ใช้ ChindaLLM 4B กับ n8n
ทำครบทุกขั้นแล้ว คุณจะได้ workflow ใน n8n ที่ส่ง prompt ภาษาไทยไปให้ ChindaLLM 4B แล้วส่งคำตอบต่อไปยัง node ถัดไป
สิ่งที่ต้องมี Node.js หรือ Docker สำหรับรัน n8n และ Ollama ถ้าจะรันโมเดลบนเครื่องตัวเอง หรือบัญชี ChindaX ถ้าจะใช้ API ที่เราดูแลให้
1. เปิด n8n
- npx
- npm
- Docker
npx n8n
npm install n8n -g
n8n start
docker run -it --rm \
  --name n8n \
  -p 5678:5678 \
  -v ~/.n8n:/home/node/.n8n \
  n8nio/n8n
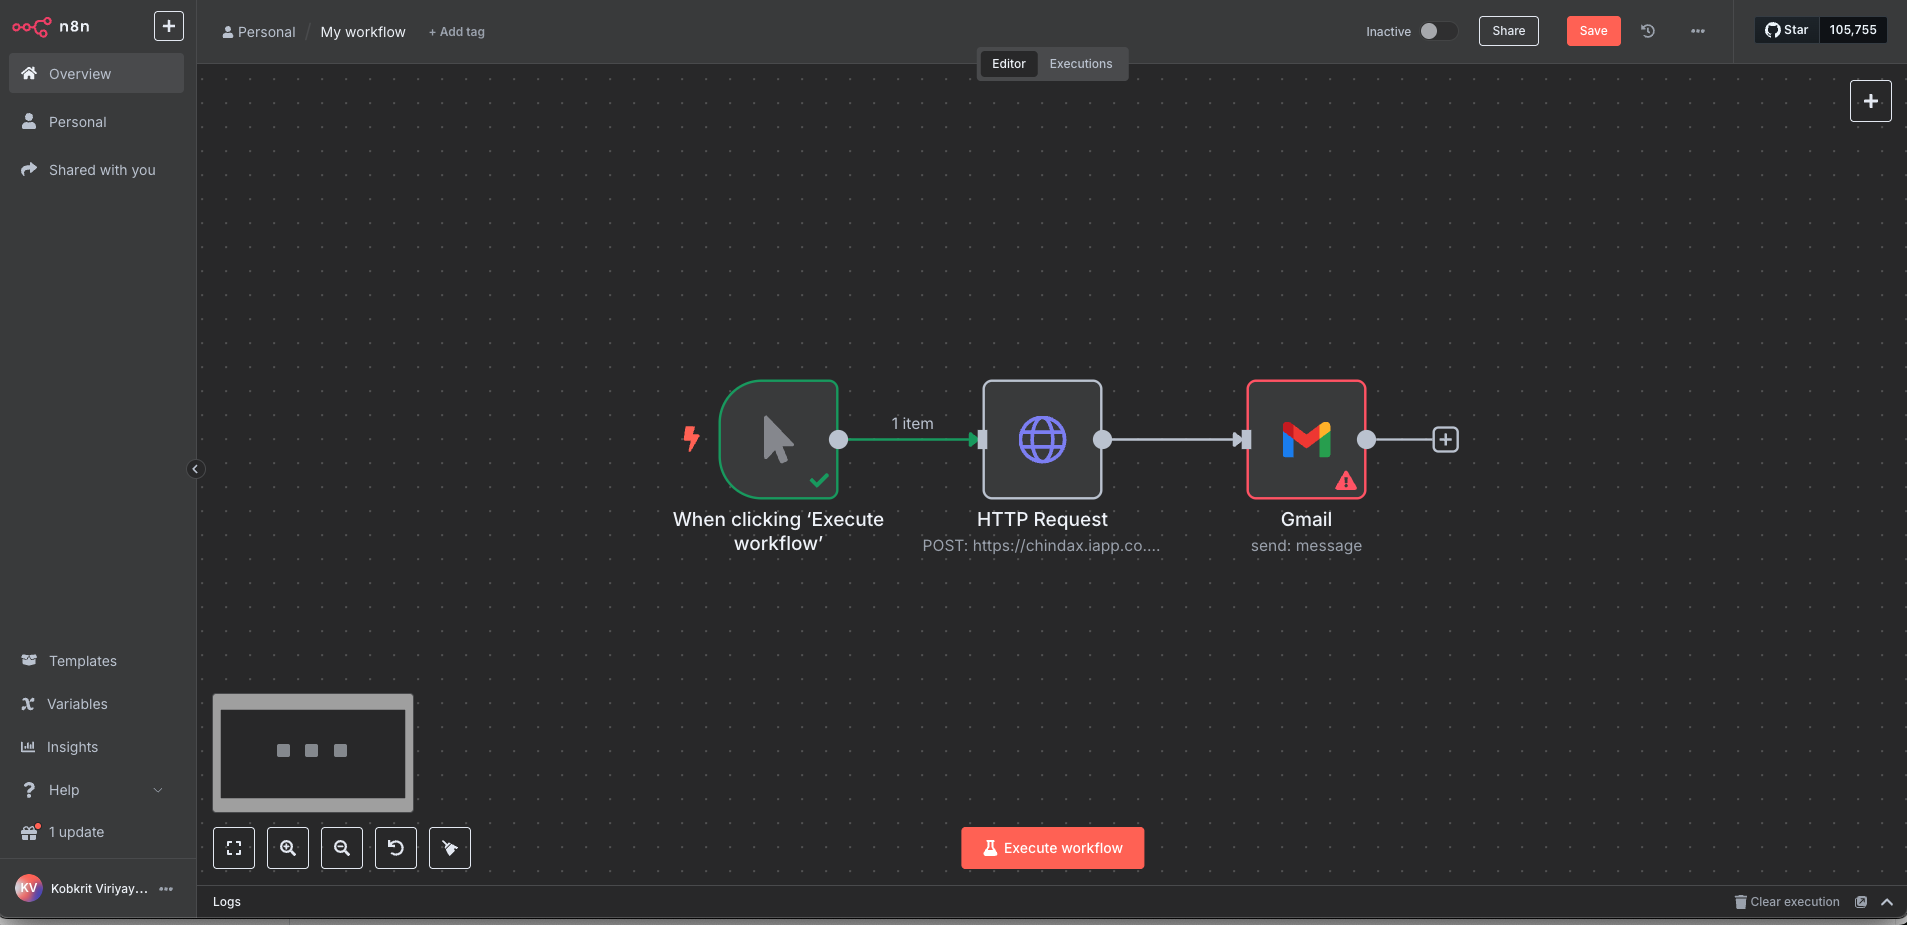
เปิด http://localhost:5678 สร้าง workflow ใหม่ แล้วเพิ่ม node Manual Trigger
2. เตรียมโมเดล
- Ollama (บนเครื่องคุณ)
- ChindaX (ไม่ต้องติดตั้ง)
curl -fsSL https://ollama.com/install.sh | sh
ollama pull iapp/chinda-qwen3-4b
ollama serve
API จะพร้อมใช้งานที่ http://localhost:11434
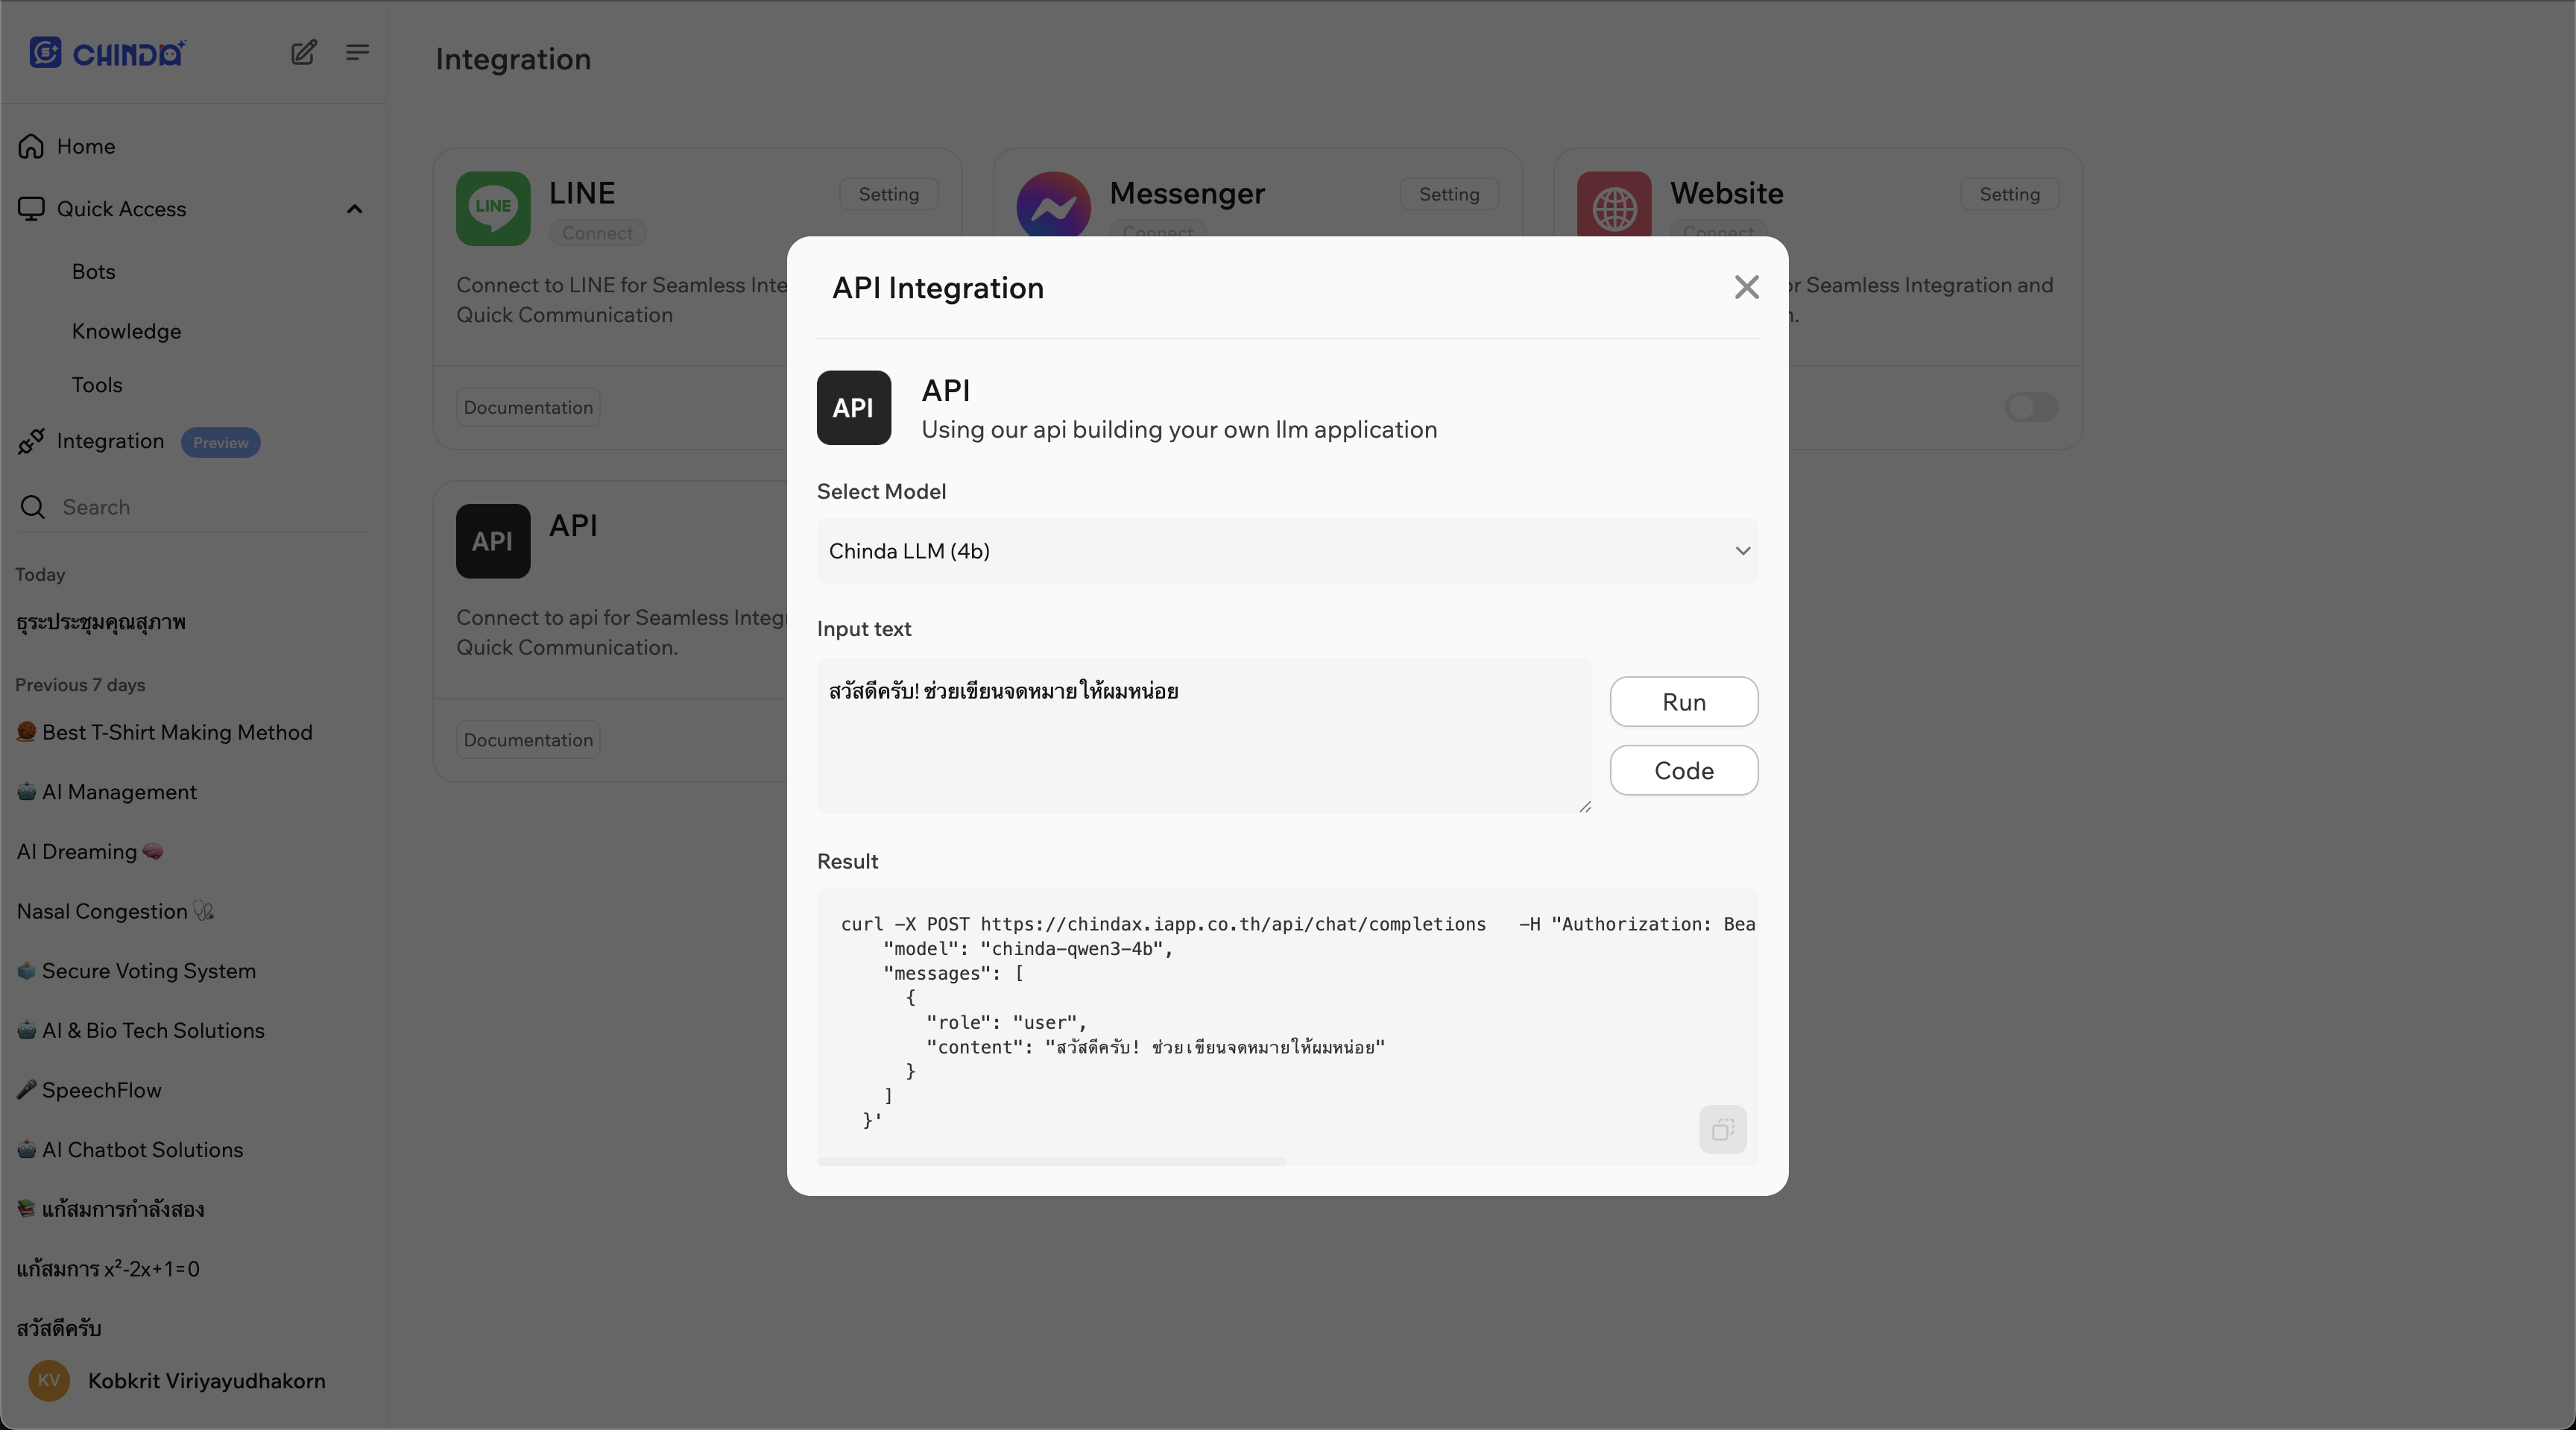
เข้าสู่ระบบที่ chindax.iapp.co.th เปิดเมนู Integration กด Setting ที่การ์ด API แล้วคัดลอก URL กับ Bearer token
3. เพิ่ม node HTTP Request
เพิ่ม node HTTP Request ต่อจาก trigger ตั้ง Method เป็น POST เปิด Send Body แล้วตั้ง Specify Body เป็น Using JSON จากนั้นกรอกค่าตามโมเดลที่ใช้
- Ollama
- ChindaX
URL: http://localhost:11434/api/generate
Body:
{
  "model": "iapp/chinda-qwen3-4b",
  "prompt": "สวัสดีครับ ช่วยอธิบายเกี่ยวกับปัญญาประดิษฐ์ให้ฟังหน่อย",
  "stream": false
}
URL: https://chindax.iapp.co.th/api/chat/completions
เปิด Send Headers ตั้ง Specify Headers เป็น Using JSON แล้วใส่
{
  "Content-Type": "application/json",
  "Authorization": "Bearer sk-********************"
}
Body:
{
  "model": "chinda-qwen3-4b",
  "messages": [
    { "role": "user", "content": "สวัสดีครับ ช่วยเขียนจดหมายให้ผมหน่อย" }
  ]
}
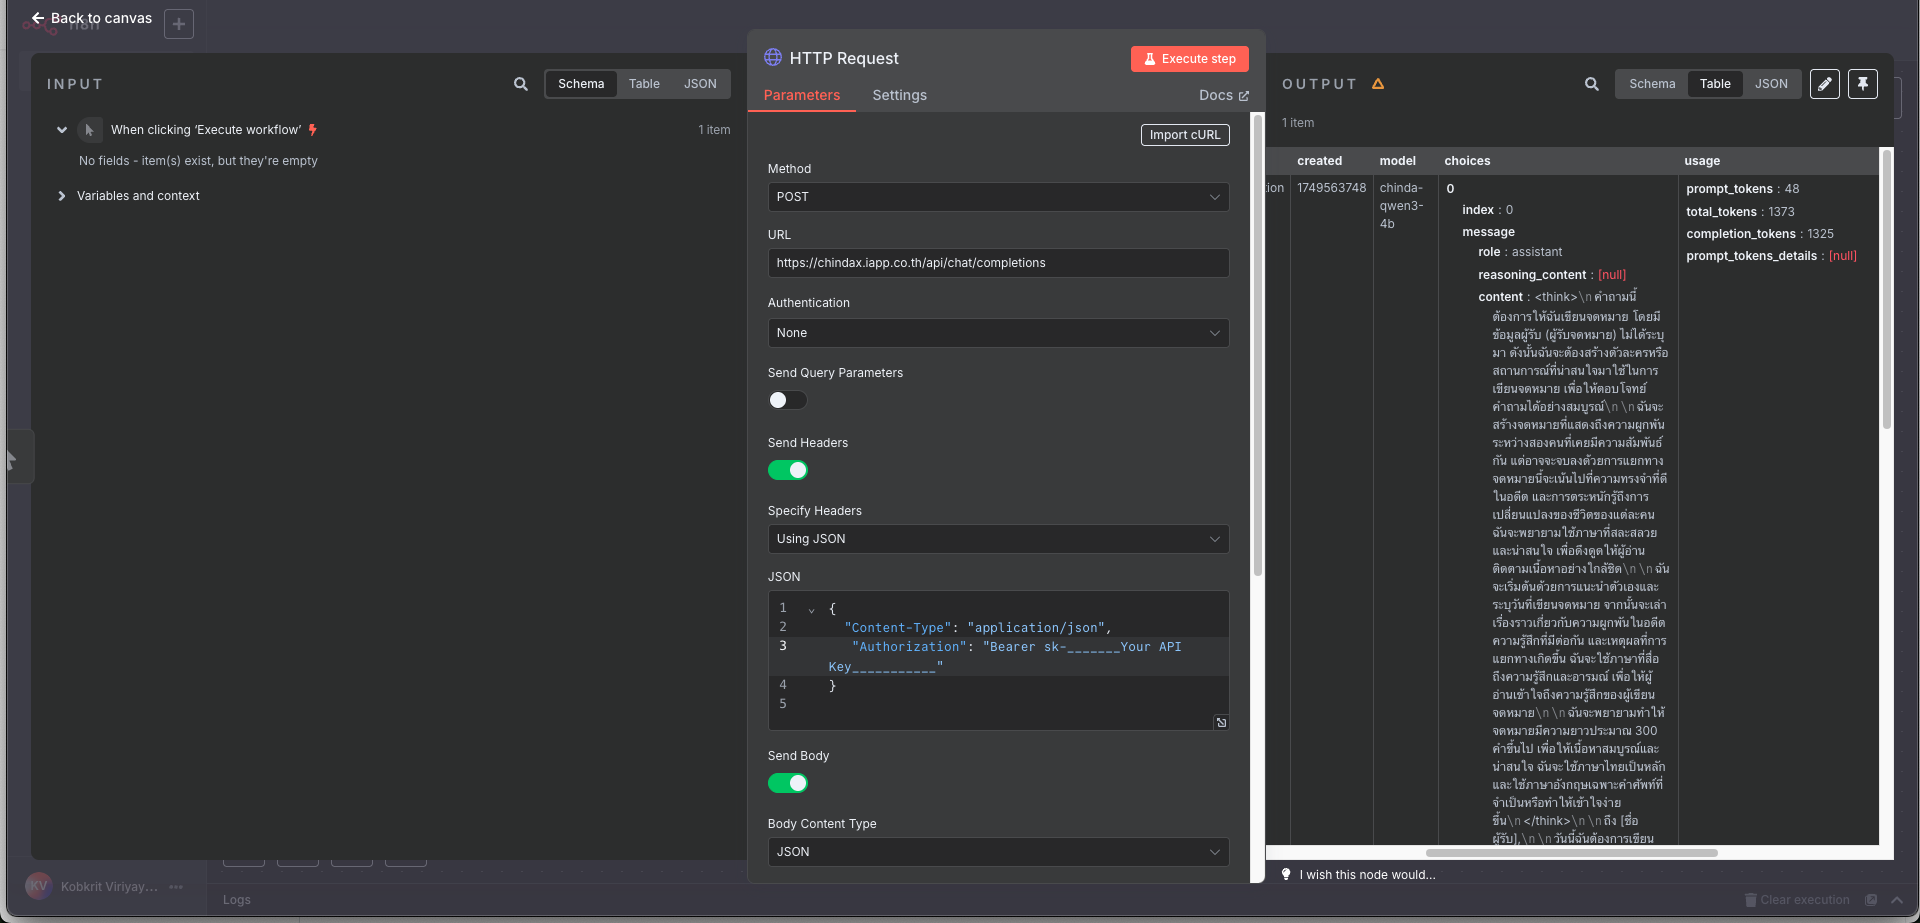
กด Execute step แล้วคำตอบจะขึ้นในช่อง Output
4. ส่งคำตอบต่อ
นำ {{ $json.response }} (Ollama) หรือ {{ $json.choices[0].message.content }} (ChindaX) ไปใส่ใน node ถัดไป เช่น Set หรือ Gmail
แก้ปัญหา
Error: connect ECONNREFUSED 127.0.0.1:11434Ollama ยังไม่ได้รัน ให้สั่งollama serveถ้ารัน n8n ด้วย Dockerlocalhostจะหมายถึงตัว container เอง ไม่ใช่เครื่องของคุณ ให้เปิด n8n ด้วย npx หรือ npm แทน หรือใช้ ChindaX- workflow หมดเวลา (timeout) ใน node HTTP Request เปิด Options เพิ่ม Timeout แล้วตั้งเป็น 30000 (30 วินาที) หรือมากกว่า
- คำตอบขึ้นต้นด้วย
<think>ส่วนนั้นคือขั้นตอนคิดของโมเดล ใช้ node Set หรือ Code ตัดข้อความตั้งแต่ต้นจนถึง</think>ออกก่อนส่งต่อ
ผลทดสอบและสัญญาอนุญาต Apache 2.0 ของโมเดลอยู่ที่หน้า ChindaLLM 4B ส่วนคู่มือ n8n อยู่ที่ docs.n8n.io