โอเพนเวท
OpenThai 2.0 Legal
โมเดลกฎหมายไทยที่จำตัวบทได้ และอ้างมาตราที่ใช้
- พารามิเตอร์30Bทำงานจริง 3B
- รันเองได้ตั้งแต่24GB VRAM
- Citation F1 เมื่อให้ตัวบท0.99
- Context256Ktokens
ดาวน์โหลดโมเดลเรียกใช้ API ที่โฮสต์ให้
เปิดน้ำหนักโมเดลเมื่อ 24 กรกฎาคม 2569 ส่วน API ที่โฮสต์ให้คิด 0.01 / 0.02 IC ต่อ 1K tokens ของ Input / Output
ทำอะไรได้บ้าง
- อ้างมาตราที่ใช้ตอบเป็นภาษาไทย พร้อมชื่อกฎหมายและมาตราที่ใช้ เป็น JSON ที่โค้ดของคุณตรวจต่อได้
- จำตัวบทได้แม้ไม่ใส่ตัวบทมาในคำถาม ก็จำประมวลกฎหมายแพ่งและพาณิชย์ได้ราว 4 เท่าของ Qwen3.6-35B
- เขียนวิเคราะห์กฎหมายชนะ Qwen3.6-35B ทั้งการอ้างอิง ข้อวินิจฉัย ความครอบคลุม และคุณภาพการเขียน ประเมินจากคดีศาลฎีกา
- รันบนเครื่องของคุณรันน้ำหนักแบบ 4-bit บน GPU 24 GB ตัวเดียว ข้อมูลคดีจึงไม่ออกนอกเครือข่ายของคุณ
ทดลองใช้
ถามเป็นภาษาไทย คำตอบอ้างอิงกฎหมายไทย 39 ฉบับ ราว 6,300 มาตรา และแสดงมาตราที่ใช้ทุกครั้ง
วิเคราะห์กฎหมายแบบความเรียงเต็มรูปแบบ พร้อมอ้างมาตราจากตัวบทฉบับปัจจุบันที่ระบบค้นให้
มุมมองนักพัฒนา — คำสั่ง API เบื้องหลังเดโมนี้
คำสั่ง curl นี้อัปเดตสดตามคำถาม โหมด และตัวเลือกที่คุณตั้งด้านบน คัดลอกไปรันในเทอร์มินัลด้วย API key ของคุณได้เลย — เป็นคำขอเดียวกับที่หน้านี้ส่งจริง
curl -s https://api.iapp.co.th/v3/llm/openthai2p0-legal/chat/completions \
  -H "Content-Type: application/json" \
  -H "apikey: YOUR_IAPP_API_KEY" \
  -d '{
  "model": "openthai2.0-legal",
  "rag": true,
  "rag_inject": "system",
  "messages": [
    {
      "role": "system",
      "content": "You are a Thai legal expert. Answer with legal analysis and cite the relevant มาตรา."
    },
    {
      "role": "user",
      "content": "จำเลยขีดฆ่าและฉีกเอกสารหลักฐานแห่งหนี้ แม้ยังอ่านได้ ถือเป็นความผิดสำเร็จหรือเพียงพยายามกระทำผิด"
    }
  ],
  "temperature": 0,
  "top_p": 1,
  "max_tokens": 4096,
  "chat_template_kwargs": {
    "enable_thinking": true
  },
  "stream": true,
  "stream_options": {
    "include_usage": true
  }
}'
ผลลัพธ์เป็นเครื่องมือช่วยตัดสินใจ มิใช่คำปรึกษาทางกฎหมาย โปรดตรวจสอบการอ้างอิงกับตัวบทฉบับปัจจุบันทุกครั้ง
ผลการทดสอบ
- กระดานคะแนน
- ตาราง
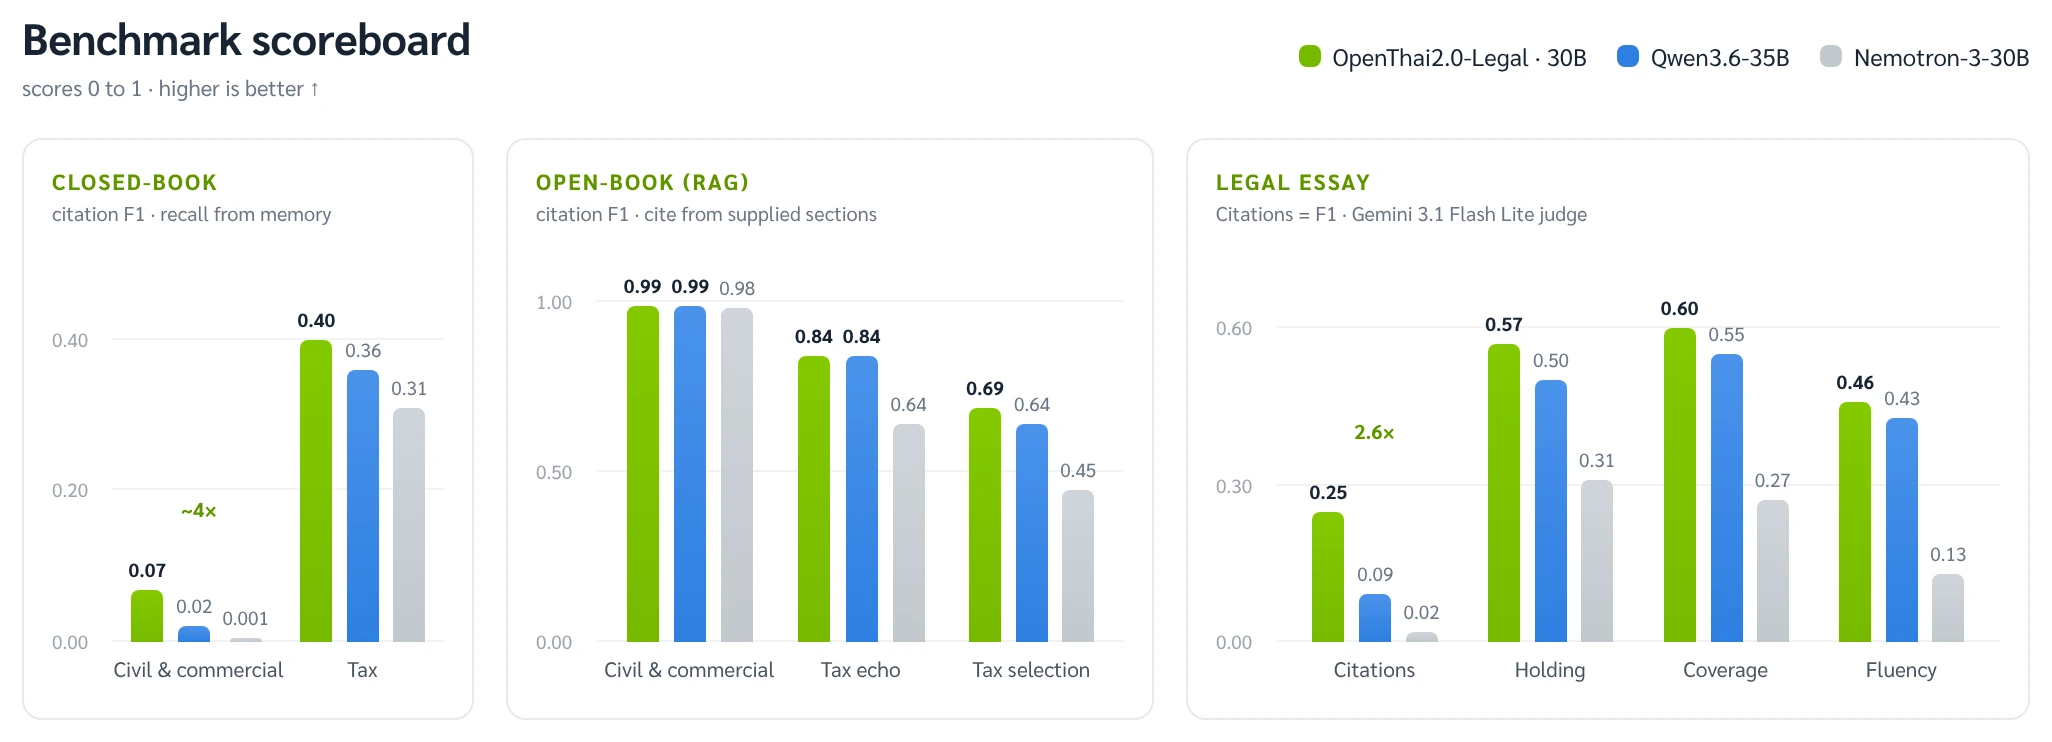
| การทดสอบ (คะแนน 0 ถึง 1) | OpenThai 2.0 Legal | Qwen3.6-35B | โมเดลฐาน |
|---|---|---|---|
| ประมวลกฎหมายแพ่งและพาณิชย์ ให้ตัวบทมาในคำถาม (n=3,729) | 0.99 | 0.99 | 0.98 |
| ประมวลกฎหมายแพ่งและพาณิชย์ ตอบจากความจำ (n=3,729) | 0.07 | 0.02 | 0.001 |
| ประมวลรัษฎากร เลือกมาตราที่ใช้บังคับท่ามกลางตัวลวง (n=50) | 0.69 | 0.64 | 0.45 |
| บทวิเคราะห์คดีศาลฎีกา อ้างอิงถูกต้อง (n=72) | 0.25 | 0.09 | 0.02 |
| บทวิเคราะห์คดีศาลฎีกา ข้อวินิจฉัยถูกต้อง (n=72) | 0.57 | 0.50 | 0.31 |
แถวที่วัดการอ้างอิงใช้ตัวให้คะแนน citation-F1 ของ NitiBench (รันครั้งเดียว temperature 0 ปิดโหมดคิด) ส่วนข้อวินิจฉัย ความครอบคลุม และคุณภาพการเขียนของบทวิเคราะห์ ให้ LLM เป็นผู้ตัดสิน ทุกโมเดลรันใหม่ภายใต้โปรโตคอลเดียวกัน และกระดานคะแนนแสดงครบทุกด้าน
วิธีรัน
- API ที่โฮสต์ให้
- curl
- vLLM
- NVIDIA NIM
เรียกใช้ด้วย iApp API key (สมัครสมาชิก แล้วไปที่ API Keys) คิด 0.01 / 0.02 IC ต่อ 1K tokens ของ Input / Output จำกัด 30 requests ต่อนาที ระบบค้นคืนตัวบทเปิดเป็นค่าเริ่มต้น และมาตราที่ใช้จะส่งกลับมาใน retrieved_documents ดูพารามิเตอร์ทั้งหมดได้ที่ API reference
from openai import OpenAI
client = OpenAI(base_url="https://api.iapp.co.th/v3/llm/openthai2p0-legal", api_key="YOUR_IAPP_API_KEY")

r = client.chat.completions.create(
    model="openthai2.0-legal",
    messages=[{"role": "user", "content": "ลักทรัพย์ในเวลากลางคืน ผิดมาตราใด"}],
    max_tokens=1024,
    # extra_body={"rag": False}  # เรียกโมเดลเปล่า (ปิดตำรา)
)
print(r.choices[0].message.content)
print(r.model_extra.get("retrieved_documents"))  # มาตราที่คำตอบใช้อ้างอิง
curl -s https://api.iapp.co.th/v3/llm/openthai2p0-legal/chat/completions \
  -H "Content-Type: application/json" -H "apikey: YOUR_IAPP_API_KEY" \
  -d '{"model":"openthai2.0-legal","messages":[{"role":"user","content":"ลักทรัพย์ในเวลากลางคืน ผิดมาตราใด"}],"max_tokens":1024}'
ทดสอบแล้วบน vLLM 0.19.1 กับ GPU H100 (80 GB) สองตัว หากใช้ GPU ตัวเดียว ให้รันน้ำหนักแบบ NVFP4 (4-bit) บนการ์ดที่มี VRAM อย่างน้อย 24 GB
vllm serve iapp/openthai2.0-legal-thaillm-nemotron-3-nano-30b-a3b \
  --tensor-parallel-size 2 --trust-remote-code \
  --max-model-len 32768 --enforce-eager
ใช้แท็กคอนเทนเนอร์ล่าสุดจาก NVIDIA NIM for LLMs catalog โดย NIM ให้บริการ API แบบ OpenAI-compatible เหมือน vLLM
docker run --rm --gpus all --shm-size=16g \
  -v <path-to-model>:/model \
  -e NIM_MODEL_NAME=/model \
  -e NIM_SERVED_MODEL_NAME=openthai2.0-legal \
  -p 8000:8000 \
  nvcr.io/nim/nvidia/llm-nim:latest
ค่าที่ต้องตั้งให้ถูก
| รูปแบบคำตอบ | Sampling | Max tokens |
|---|---|---|
| อ้างอิงมาตรา เป็น JSON | temperature 0.0 ปิดโหมดคิด | 1,024 |
| บทวิเคราะห์ | temperature 0.7, top_p 0.9 | 2,048 ถึง 4,096 |
ใส่ "chat_template_kwargs": {"enable_thinking": true} เพื่อดูการให้เหตุผลใน <think>...</think> และตั้ง --max-model-len ไว้ที่ 32768 ขึ้นไป เพราะตัวบทจริงของประมวลรัษฎากรยาวเกิน context window ที่เล็กกว่านี้
Prompt สำหรับคำตอบอ้างอิงแบบ JSON และบทวิเคราะห์
เมื่อใส่ตัวบทมาในคำถาม (โหมด RAG) กับเซิร์ฟเวอร์ที่รันเอง:
from openai import OpenAI
client = OpenAI(base_url="http://localhost:8000/v1", api_key="none")

SYSTEM = ("You are OpenThaiGPT-Legal, an expert assistant on Thai law. You are given a legal "
          "question and the exact statutory sections needed to answer it. Reason step by step in "
          "English, then give the final answer in Thai. Cite ONLY sections present in the provided "
          "context, using each section's exact law_name and bare section number (e.g. 132, 77/1). "
          'Output the final answer as JSON: {"answer": "<Thai answer>", '
          '"citations": [{"law": "<law_name>", "section": "<bare id>"}]}.')

USER = """Provided context:
<law law_name="ประมวลกฎหมายแพ่งและพาณิชย์" section="420">
ผู้ใดจงใจหรือประมาทเลินเล่อ ทำต่อบุคคลอื่นโดยผิดกฎหมายให้เขาเสียหาย ... จำต้องใช้ค่าสินไหมทดแทนเพื่อการนั้น
</law>

Question (ตอบเป็นภาษาไทย):
นาย ก. ขับรถโดยประมาทชนรถของนาย ข. เสียหาย นาย ก. ต้องรับผิดตามกฎหมายใด"""

r = client.chat.completions.create(
    model="openthai2.0-legal-thaillm-nemotron-3-nano-30b-a3b",
    messages=[{"role": "system", "content": SYSTEM}, {"role": "user", "content": USER}],
    temperature=0.0, max_tokens=1024,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}})
print(r.choices[0].message.content)
ผลลัพธ์จริงของโมเดล:
{"answer": "นาย ก. ต้องรับผิดตามประมวลกฎหมายแพ่งและพาณิชย์ มาตรา 420",
 "citations": [{"law": "ประมวลกฎหมายแพ่งและพาณิชย์", "section": "420"}]}
หากให้ตอบจากความจำโดยไม่ใส่ตัวบท ให้ส่ง system prompt นี้พร้อมคำถามอย่างเดียว:
SYSTEM = ("You are an expert on Thai law. You are given ONLY a legal question, with NO reference "
          "material provided. Using your OWN knowledge of Thai statutes, answer in Thai and cite the "
          "specific sections that apply (law name + bare section number, มาตรา). "
          'Output ONLY a JSON object: {"answer":"<Thai answer>","citations":[{"law":"<law name>",'
          '"section":"<bare section number e.g. 40 or 77/1>"}]}.')
สำหรับบทวิเคราะห์ ให้ส่ง system prompt สั้น ๆ นี้พร้อมคำถาม โมเดลจะอ้างมาตราในเนื้อความแทน JSON:
SYSTEM = "You are a Thai legal expert. Answer the question with legal analysis and cite the relevant มาตรา."
หากต้องการต่อระบบค้นคืนของคุณเอง ทำตามคู่มือ Open WebUI และ OpenThaiRAG และตัดตัวบทเป็นหนึ่งมาตราต่อหนึ่ง chunk พร้อม metadata law_name และ section หากต้องการนำไปใช้ในองค์กร หรือปรับจูนกับคลังเอกสารของคุณเอง ติดต่อ sale@iapp.co.th หรือโทร 02-124-4041
ข้อจำกัด
- เป็นเครื่องมือช่วยตัดสินใจ ไม่ใช่คำปรึกษาทางกฎหมาย ผู้ประกอบวิชาชีพต้องตรวจการอ้างอิงทุกครั้งกับตัวบทฉบับปัจจุบัน
- คำตอบอิงตามมาตราที่ได้รับ ถ้าระบบค้นคืนส่งมาตราผิดมา คำตอบก็ผิดตาม ในการทดสอบที่ให้ตัวบทมาในคำถาม การเลือกมาตราที่ใช้บังคับท่ามกลางมาตราที่ใกล้เคียงกันได้คะแนนต่ำที่สุดในทุกโมเดล
- ฝึกบนกฎหมายไทย (ประมวลรัษฎากร ประมวลกฎหมายแพ่งและพาณิชย์ และกฎหมายที่เกี่ยวข้อง) และข้อหารือของกรมสรรพากร สาขาเฉพาะทางและการแก้ไขกฎหมายล่าสุดยังครอบคลุมน้อยกว่า
สัญญาอนุญาต
NVIDIA Open Model Agreement โมเดลนี้ฝึกต่อจากส่วนประมวลผลข้อความของ NVIDIA Nemotron-3-Nano-Omni-30B-A3B-Reasoning ด้วย continued pretraining บนแบบฝึกตัวบท 360,985 ชุด ตามด้วย fine-tuning บนคำตอบข้อสอบและบทวิเคราะห์ 16,436 ตัวอย่าง แล้วจึง reinforcement learning บนคำถามที่ให้คะแนนแล้ว 8,568 ข้อ โดยใช้ citation F1 เป็นรางวัล อ่านรายละเอียดได้ในบทความเปิดตัว
ข้อมูลฝึกด้านบทวิเคราะห์บางส่วนมาจากเอกสารการสอบเนติบัณฑิต โปรดตรวจสอบเงื่อนไขการเผยแพร่ซ้ำให้เหมาะกับการใช้งานของคุณ ประเมินผลด้วย NitiBench (VISAI-AI, MIT) และข้อมูล fine-tuning สร้างจาก WangchanX-Legal-ThaiCCL (VISTEC, MIT) พัฒนาโดยทีม OpenThai (AIEAT และ iApp Technology) ร่วมกับสถาบันข้อมูลขนาดใหญ่ โครงการ ThaiLLM และ NVIDIA