在 n8n 中使用 ChindaLLM 4B
完成后,您将得到一个 n8n 工作流:把泰语提示词发送给 ChindaLLM 4B,并把回答传给下一个节点。
准备工作:运行 n8n 需要 Node.js 或 Docker;在本机运行模型需要 Ollama,使用托管 API 则需要一个 ChindaX 账号。
1. 启动 n8n
- npx
- npm
- Docker
npx n8n
npm install n8n -g
n8n start
docker run -it --rm \
  --name n8n \
  -p 5678:5678 \
  -v ~/.n8n:/home/node/.n8n \
  n8nio/n8n
打开 http://localhost:5678,新建一个工作流,并添加 Manual Trigger 节点。
2. 准备模型
- Ollama(本机)
- ChindaX(托管)
curl -fsSL https://ollama.com/install.sh | sh
ollama pull iapp/chinda-qwen3-4b
ollama serve
API 监听 http://localhost:11434。
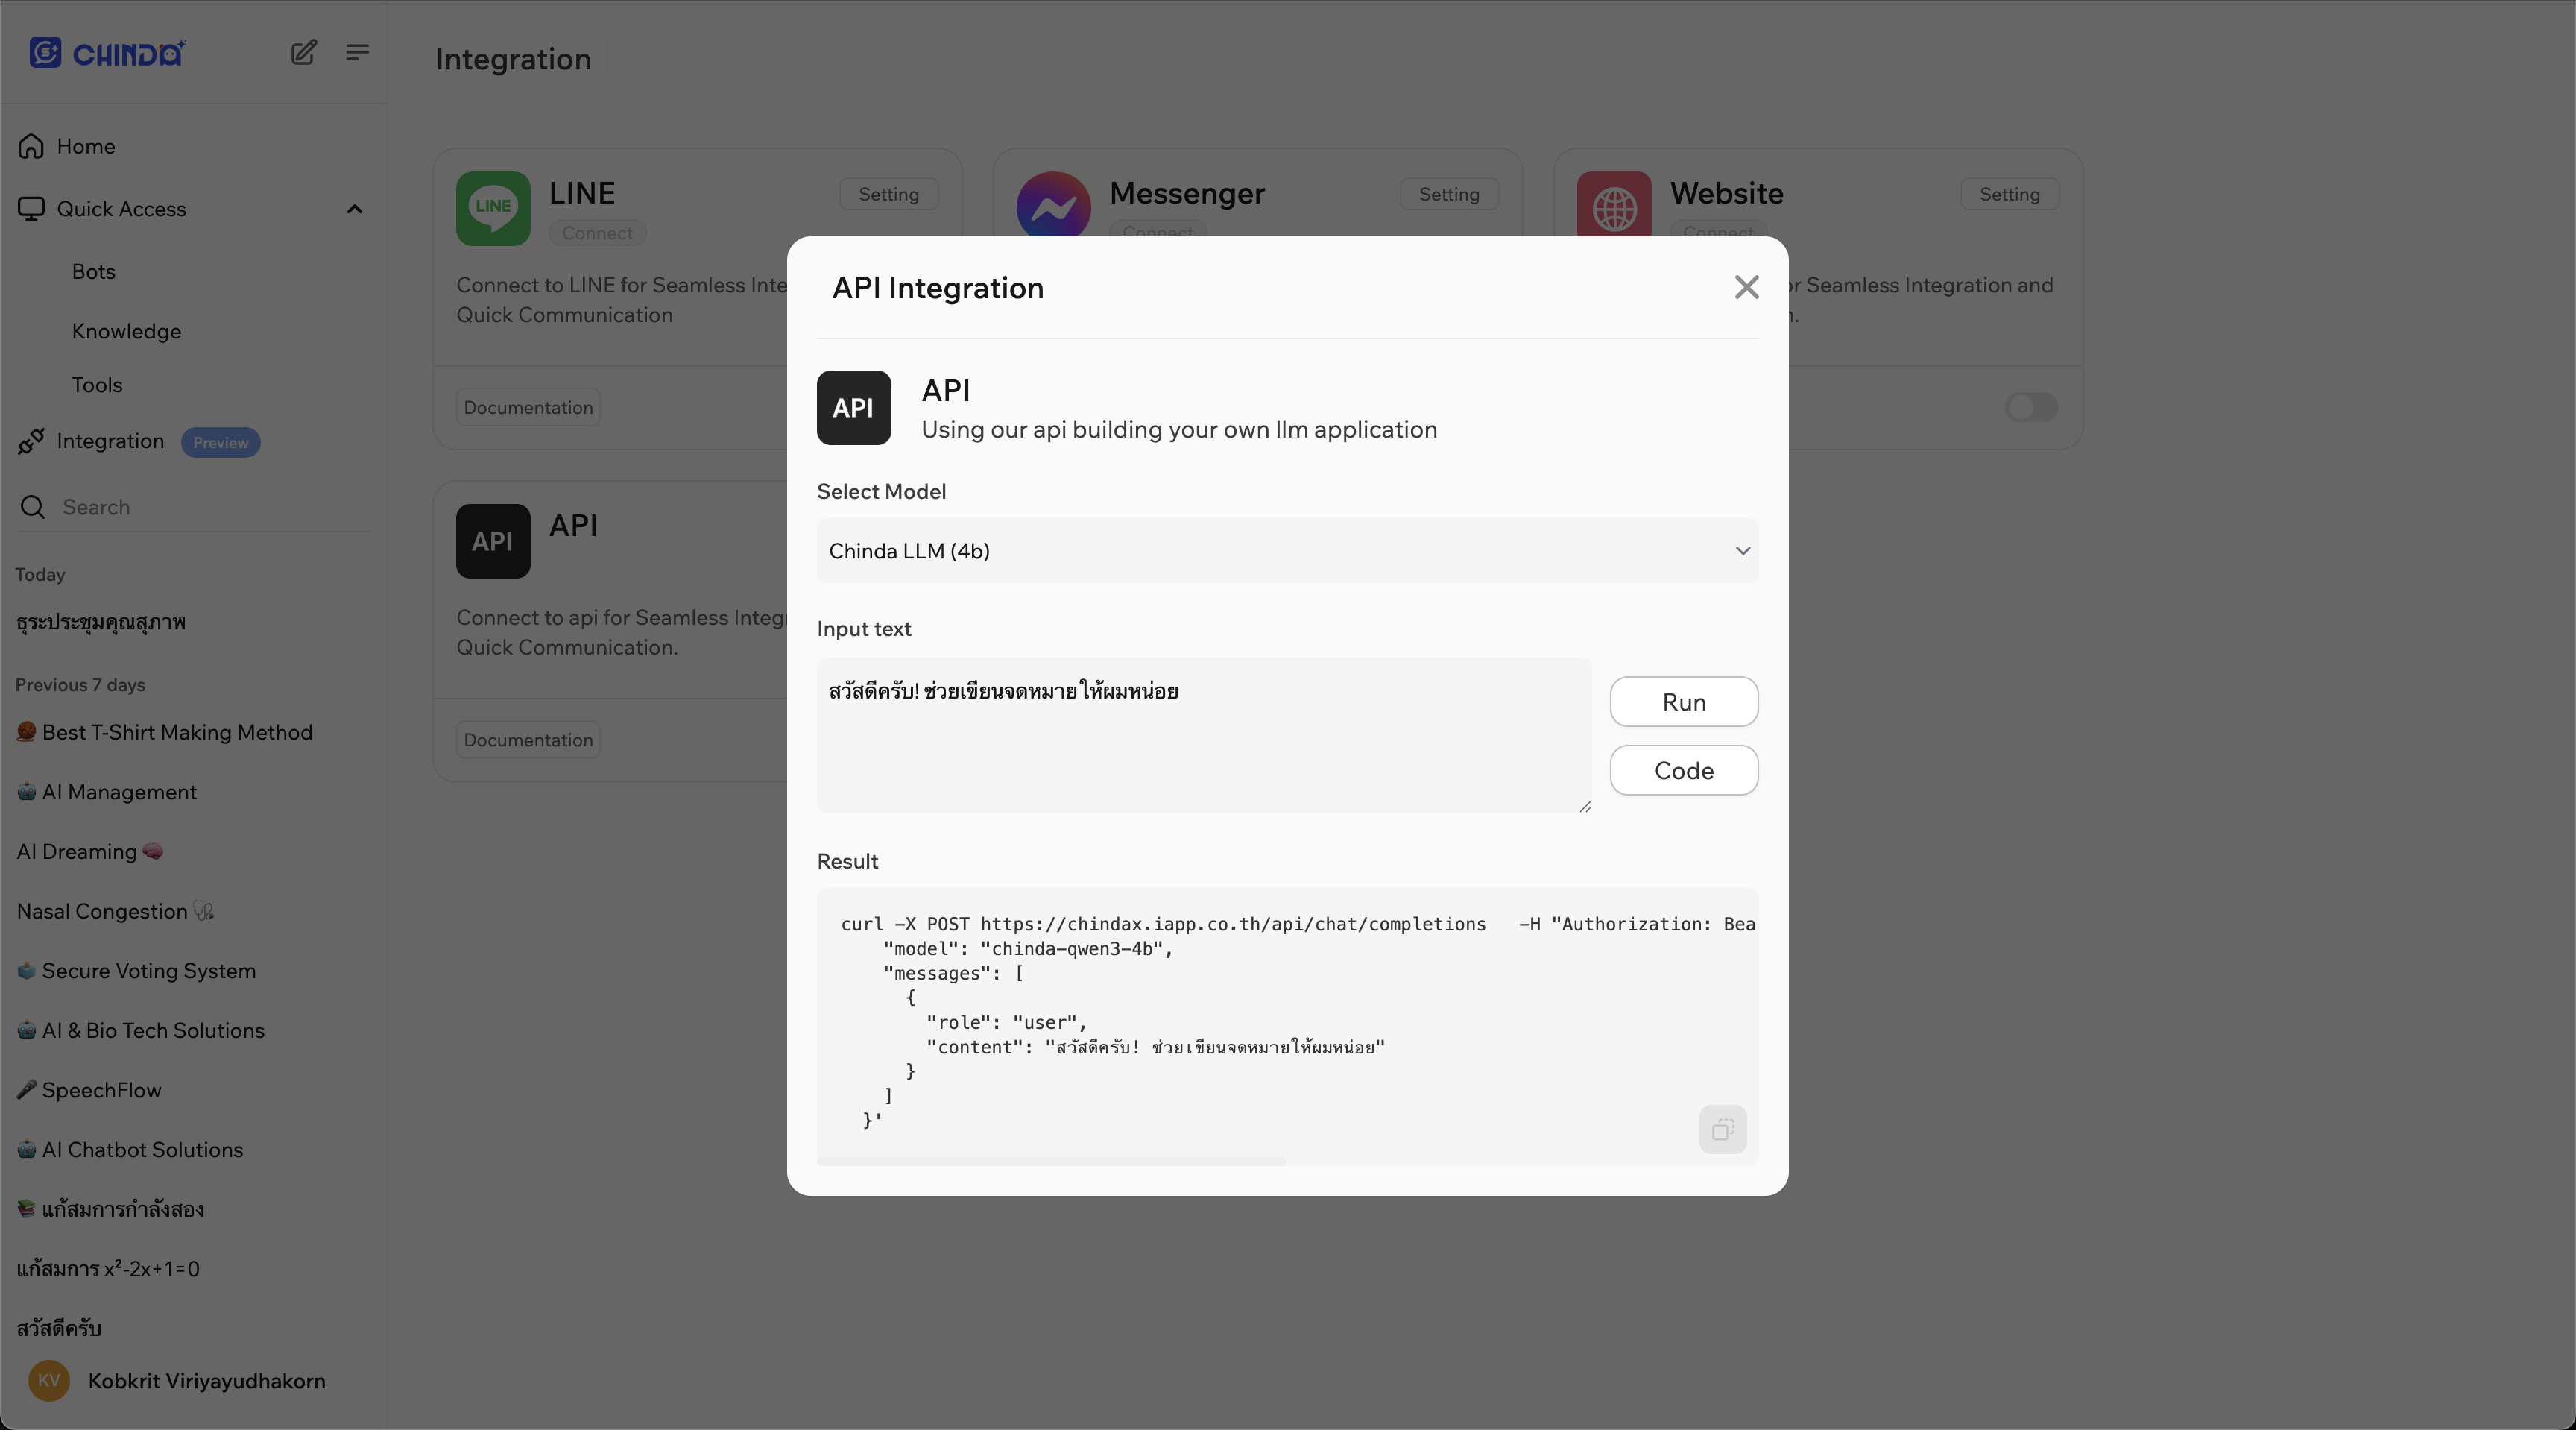
登录 chindax.iapp.co.th,打开 Integration,点击 API 卡片上的 Setting,复制 URL 和 Bearer token。
3. 添加 HTTP Request 节点
在触发器之后添加 HTTP Request 节点,将 Method 设为 POST,打开 Send Body 并把 Specify Body 设为 Using JSON,然后按所用的模型填写。
- Ollama
- ChindaX
URL:http://localhost:11434/api/generate
请求体:
{
  "model": "iapp/chinda-qwen3-4b",
  "prompt": "สวัสดีครับ ช่วยอธิบายเกี่ยวกับปัญญาประดิษฐ์ให้ฟังหน่อย",
  "stream": false
}
URL:https://chindax.iapp.co.th/api/chat/completions
打开 Send Headers,把 Specify Headers 设为 Using JSON,填写:
{
  "Content-Type": "application/json",
  "Authorization": "Bearer sk-********************"
}
请求体:
{
  "model": "chinda-qwen3-4b",
  "messages": [
    { "role": "user", "content": "สวัสดีครับ ช่วยเขียนจดหมายให้ผมหน่อย" }
  ]
}
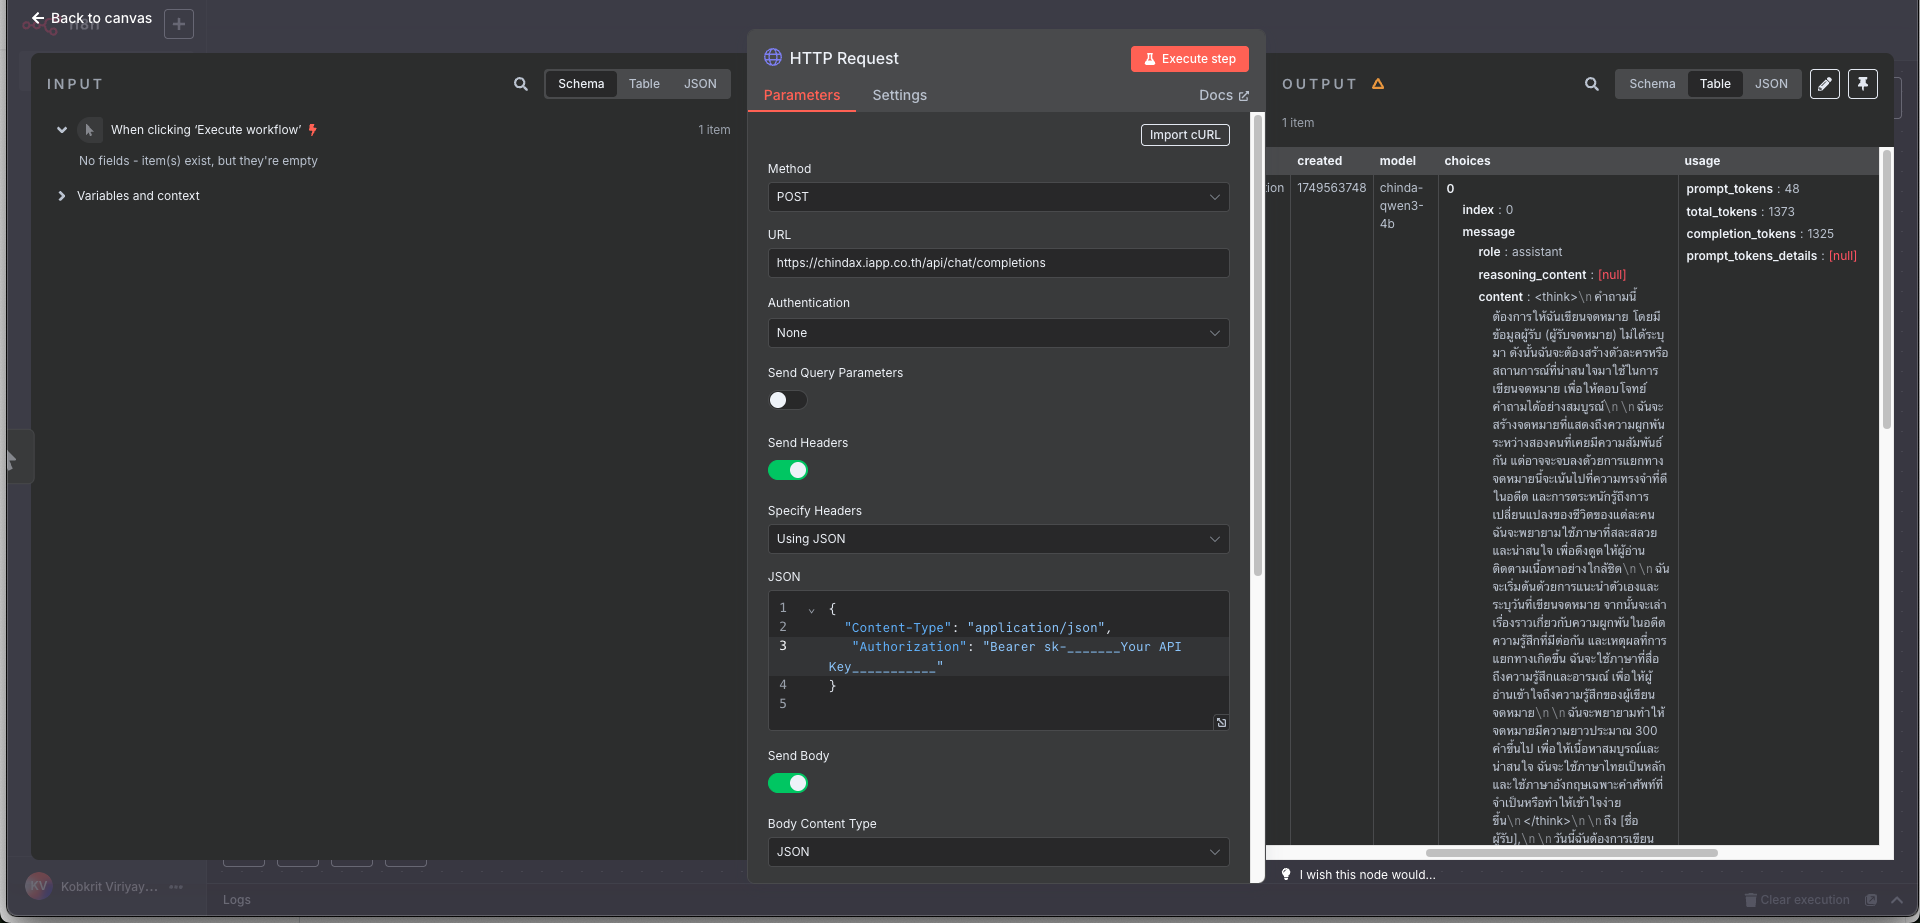
点击 Execute step,回答会显示在 Output 面板中。
4. 传递回答
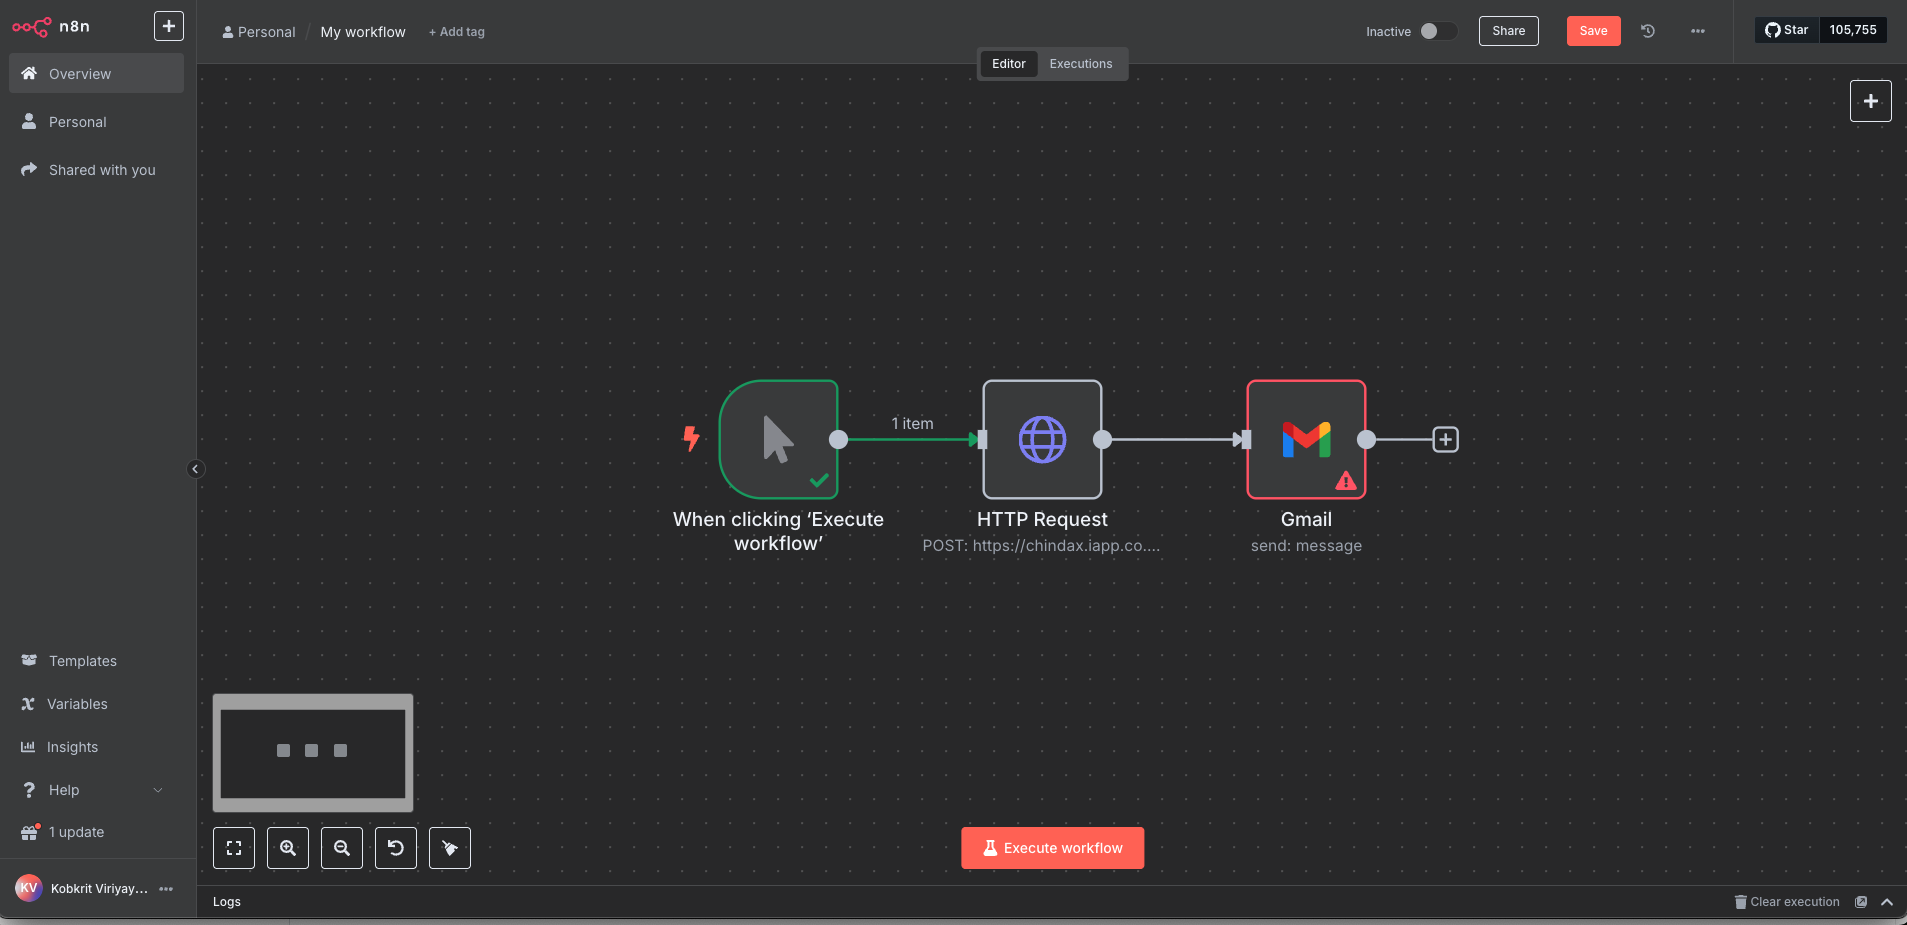
把 {{ $json.response }}(Ollama)或 {{ $json.choices[0].message.content }}(ChindaX)映射到下一个节点,例如 Set 或 Gmail。
故障排除
Error: connect ECONNREFUSED 127.0.0.1:11434:Ollama 没有运行,请执行ollama serve。如果 n8n 运行在 Docker 中,localhost指的是容器本身而不是您的电脑,请改用 npx 或 npm 启动 n8n,或使用 ChindaX。- 工作流超时:在 HTTP Request 节点中打开 Options,添加 Timeout,设为 30000(30 秒)或更大。
- 回答以
<think>开头:这是模型的推理过程。发送前请在 Set 或 Code 节点中删除</think>及其之前的内容。
模型的基准测试结果和 Apache 2.0 许可证见 ChindaLLM 4B 页面;n8n 的文档见 docs.n8n.io。