开放权重
OpenThai 2.0
一个开源模型,读得懂泰文文档与手写,了解泰国,也能调用工具。
- 参数量270亿
- 许可Apache 2.0
- 泰国全国考试83.1%443 题
- 上下文256Ktokens
2026 年 8 月 27 日开放权重。托管 API 按每 1K 输入 / 输出 token 0.01 / 0.02 IC 计费。
能做什么
- 读取泰语文档手写字符错误率 0.261,基础模型为 0.649;书籍与皇家公报页面为 0.126。
- 回答文档问题在同一个模型中读取文档并回答相关问题,无需独立的 OCR 环节。
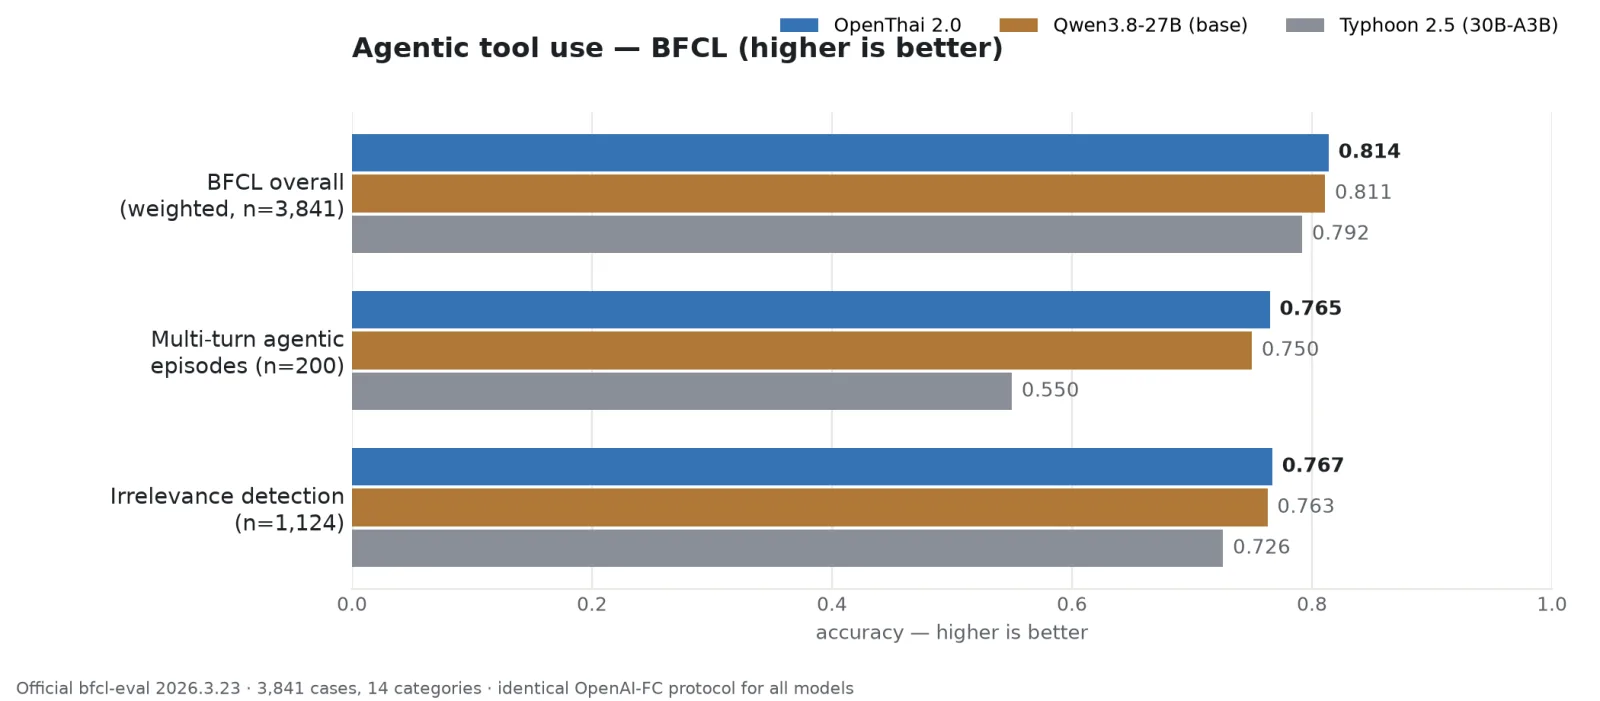
- 调用工具Berkeley Function-Calling Leaderboard 得分 0.820,领先基础模型与 Typhoon 2.5。
- 解码更快内置草稿头,H100 单流实测 75.2 对 50.1 token/秒,输出逐 token 一致。
实测
所有模型均由 iApp 在同一测试套件、同一服务配置下测得,各自使用官方推荐的提示词与参数。测试集经 n-gram 泄漏检查与训练数据隔离,手写测试集与训练数据没有任何文本重合。完整分类别结果见 Hugging Face 仓库。
- 泰语知识
- 文档读取
- 工具调用
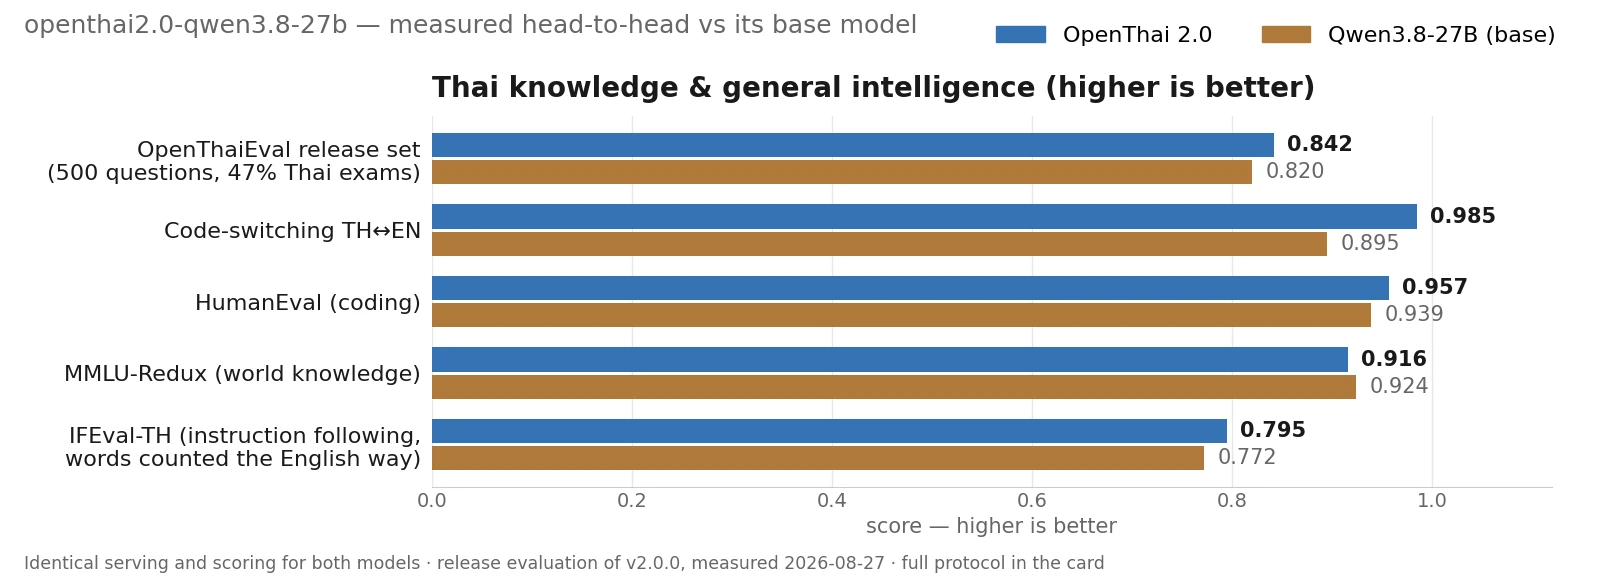
上图中 OpenThaiEval 的 0.842 是 v2.0.0 版本在发布评测 500 题上的成绩:其中 A-Level、TGAT 与 TPAT-1 共 210 题,执照考试 25 题,翻译成泰语的国际基准 265 题(53%),不含 O-NET 题目。图中 IFEval-TH 的分数以英文分词器统计泰语词数。在同一组 500 题上,当前版本 v2.0.3 得 86.0%,Typhoon 2.5(30B-A3B)得 74.2%,领先 11.8 个百分点(95% CI 7.8–15.6)。
2026 年 10 月 28 日在生产环境测得,OpenThai 2.0 在 OpenThaiEval 全部 443 道泰国全国考试题(含 O-NET)上的正确率为 83.1%(95% CI 79.5–86.7)。按数据集规定的泰语计词方式,v2.0.3 发布时的输出在 IFEval-TH 的 215 条提示中有 80.0% 遵循了全部指令。方法与局限:基准测试报告 (PDF)。
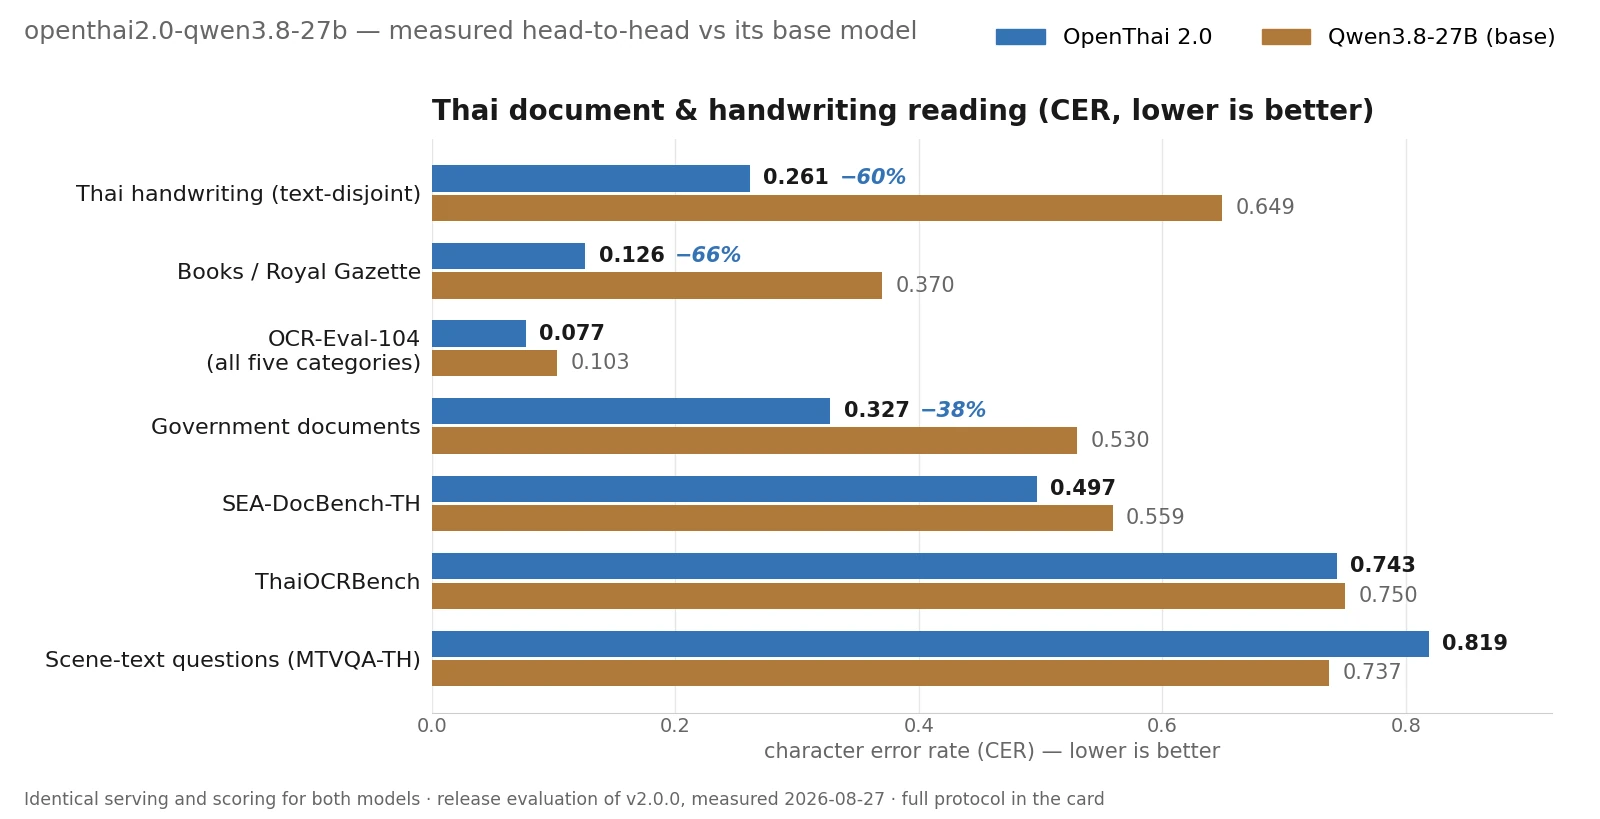
图中 OCR-Eval-104 的 0.077 涵盖全部五个类别(含手写与场景文字)。2026 年 10 月 28 日在生产环境测得,OCR-Eval-104 总体字符错误率为 0.080,其中印刷页面为 0.042;文本与训练数据不重合的手写测试集为 0.247。
运行
- 托管 API
- curl
- Ollama
- vLLM
使用 iApp API key 调用:注册,然后依次选择 API Keys、Create New API Key。按每 1K 输入 / 输出 token 0.01 / 0.02 IC 计费,每个 key 限 30 次请求/分钟。完整参考:OpenThai 2.0 API。
import base64
from openai import OpenAI

client = OpenAI(base_url="https://api.iapp.co.th/v3/llm/openthai2p0",
                api_key="YOUR_IAPP_API_KEY")

# 文本 — 用泰语随意提问
r = client.chat.completions.create(
    model="openthai2.0",
    messages=[{"role": "user", "content": "อากรแสตมป์กับภาษีมูลค่าเพิ่มต่างกันอย่างไร"}],
)
print(r.choices[0].message.content)

# 视觉 — 读取泰语文档
img = base64.b64encode(open("thai_document.jpg", "rb").read()).decode()
r = client.chat.completions.create(
    model="openthai2.0",
    messages=[{"role": "user", "content": [
        {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{img}"}},
        {"type": "text", "text": "อ่านข้อความในเอกสารนี้ทั้งหมด"},
    ]}],
    temperature=0.0,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}},
)
print(r.choices[0].message.content)
curl -s https://api.iapp.co.th/v3/llm/openthai2p0/chat/completions \
  -H "Content-Type: application/json" -H "apikey: YOUR_IAPP_API_KEY" \
  -d '{"model":"openthai2.0","messages":[{"role":"user","content":"สวัสดี"}]}'
一条命令,笔记本即可运行,来自 Ollama。
ollama run openthai/openthai2.0-qwen3.8-27b
一张 80 GB GPU(bf16 约占 56 GB),vLLM 0.19 及以上。--max-num-seqs 128 为必填:vLLM 默认值 1,024 会导致引擎启动失败。
vllm serve iapp/openthai2.0-qwen3.8-27b \
  --max-model-len 32768 --gpu-memory-utilization 0.85 \
  --max-num-seqs 128 --reasoning-parser qwen3 --trust-remote-code
服务为 OpenAI 兼容,地址 http://localhost:8000/v1,模型名 iapp/openthai2.0-qwen3.8-27b。添加 --speculative-config '{"method":"qwen3_5_mtp","num_speculative_tokens":2}' 即可启用草稿头。
Hugging Face 上的其他格式
| 格式 | 适用 |
|---|---|
| GGUF Q4_K_M / Q8_0 | llama.cpp,CPU 或消费级 GPU(17 / 29 GB),含视觉 mmproj |
| MLX 4-bit | 24 GB 以上统一内存的 Apple silicon |
| INT8 W8A8 | vLLM,约 40 GB 级 GPU |
| NVFP4 | vLLM,NVIDIA Blackwell |
需要注意的设置
| 设置 | 原因 |
|---|---|
不设 max_tokens,或至少 8,192 | 模型先推理后作答;上限 1,024 时约三分之一的回复为空。 |
仅图片转写时设 enable_thinking: false | 文本请求保持思考开启:强制关闭后,可用回答从 94% 降至 42%。 |
repetition_penalty: 1.05 | 用于长篇泰语输出。托管 API 已默认应用。 |
调用托管 API 时设 stream: true | 未使用流式传输的请求,若答案在 180 秒内未完成,将返回 HTTP 504;考试题中 15.9% 的答案推理时间超过此值。 |
限制
- 结构化抽取与基础模型持平:judged ThaiOCRBench 上为 0.568 对 0.570;在表格与关键字段上仍落后于专用模型。表单流水线请先在自己的文档上测试。
- 针对照片中场景文字的问答(MTVQA-TH)是最弱的读取项:字符错误率 0.819,基础模型为 0.737。单纯转写场景文字则并不弱:OCR-Eval-104 的 24 张场景文字图片为 0.035。
- 纯转写模型在干净印刷体与孤立手写上表现更好:Typhoon-OCR 1.5 分别为 0.014 与 0.054,但只接受固定的 OCR 提示词,无法回答问题。
- 默认以解释型风格作答,按要求简答的达成率约 40%。需要机器解析的输出请明确指定格式,例如 "ตอบเป็น JSON เท่านั้น"(仅输出 JSON)。
- 困难手写样本上约四分之一的字符仍会出错,无法辨认的输入可能产生编造的文字。未对泰语方言、竖排或旋转文字做评测。
税务、法律或医疗类回答,请结合权威来源检索与人工审核。法律领域请使用 OpenThai 2.0 Legal。
许可
Apache 2.0。基于 Qwen/Qwen3.8-27B,以 LoRA(rank 64)在约 14.3 万条经核验的数据上微调;仓库另附单独的适配器(7 GB),可加载在基础模型之上提供服务。
由 iApp 开发,与 AIEAT 联合发布。在 Siam AI Corporation 提供的 8 张 NVIDIA H100 上训练与评测。
引用
@misc{openthai2_2026,
  title  = {OpenThai 2.0: An Open Thai Knowledge and Document AI},
  author = {iApp Technology and Artificial Intelligence Entrepreneur Association of Thailand},
  year   = {2026},
  url    = {https://openthai.aieat.or.th}
}