OpenThai 2.0 ASR Streaming: โมเดลแบบเปิดที่ถอดเสียงพูดภาษาไทยเป็นข้อความ ขณะที่คนยังพูดอยู่

วันนี้เราเปิดตัว OpenThai 2.0 ASR Streaming โมเดลแบบเปิดน้ำหนักที่ถอดเสียงพูดภาษาไทยเป็นข้อความขณะที่คนยังพูดอยู่ ข้อความมาช้ากว่าเสียง 80 ถึง 1120 มิลลิวินาที จากโมเดลเดียวที่ตั้งความหน่วงได้สี่ระดับ ขนาด 0.64 พันล้านพารามิเตอร์ รันบน GPU ใบเดียวหรือบน CPU ก็ได้ และดาวน์โหลดได้ฟรีภายใต้สัญญาอนุญาต OpenMDW-1.1 โมเดลนี้คือโมเดลเบื้องหลังบริการถอดเสียงสดของเรา OpenThai ASR Realtime
หน้าโมเดล: iapp.co.th/openmodels/openthai2p0-asr-streaming · น้ำหนักโมเดล: huggingface.co/iapp/OpenThai2.0-ASR-Streaming
ทำไมต้องสตรีมมิง
คำบรรยายสด ผู้ช่วยในคอลเซ็นเตอร์ และการสั่งงานด้วยเสียง ต้องได้ข้อความขณะที่คนยังพูดอยู่ แต่โมเดลถอดเสียงภาษาไทยแบบเปิดส่วนใหญ่สร้างบน Whisper ซึ่งต้องอ่านทั้งไฟล์ หรืออย่างน้อยช่วงละ 30 วินาที ก่อนจะเขียนอะไรออกมา OpenThai 2.0 ASR Streaming อ่านเสียงเป็นช่วงสั้น ๆ และส่งสถานะต่อจากช่วงหนึ่งไปอีกช่วง จึงเขียนข้อความได้ทันทีที่เสียงเข้ามา และใช้หน่วยความจำคงที่ไม่ว่าเสียงจะยาวเท่าใด ความยาวช่วงเลือกได้ตอนถอดเสียง: 80 มิลลิวินาทีเมื่อต้องการตอบสนองเร็วที่สุด 1120 มิลลิวินาทีเมื่อต้องการความแม่นยำสูงสุด หรือ 320 และ 560 มิลลิวินาทีอยู่ระหว่างกลาง
ผลการทดสอบ
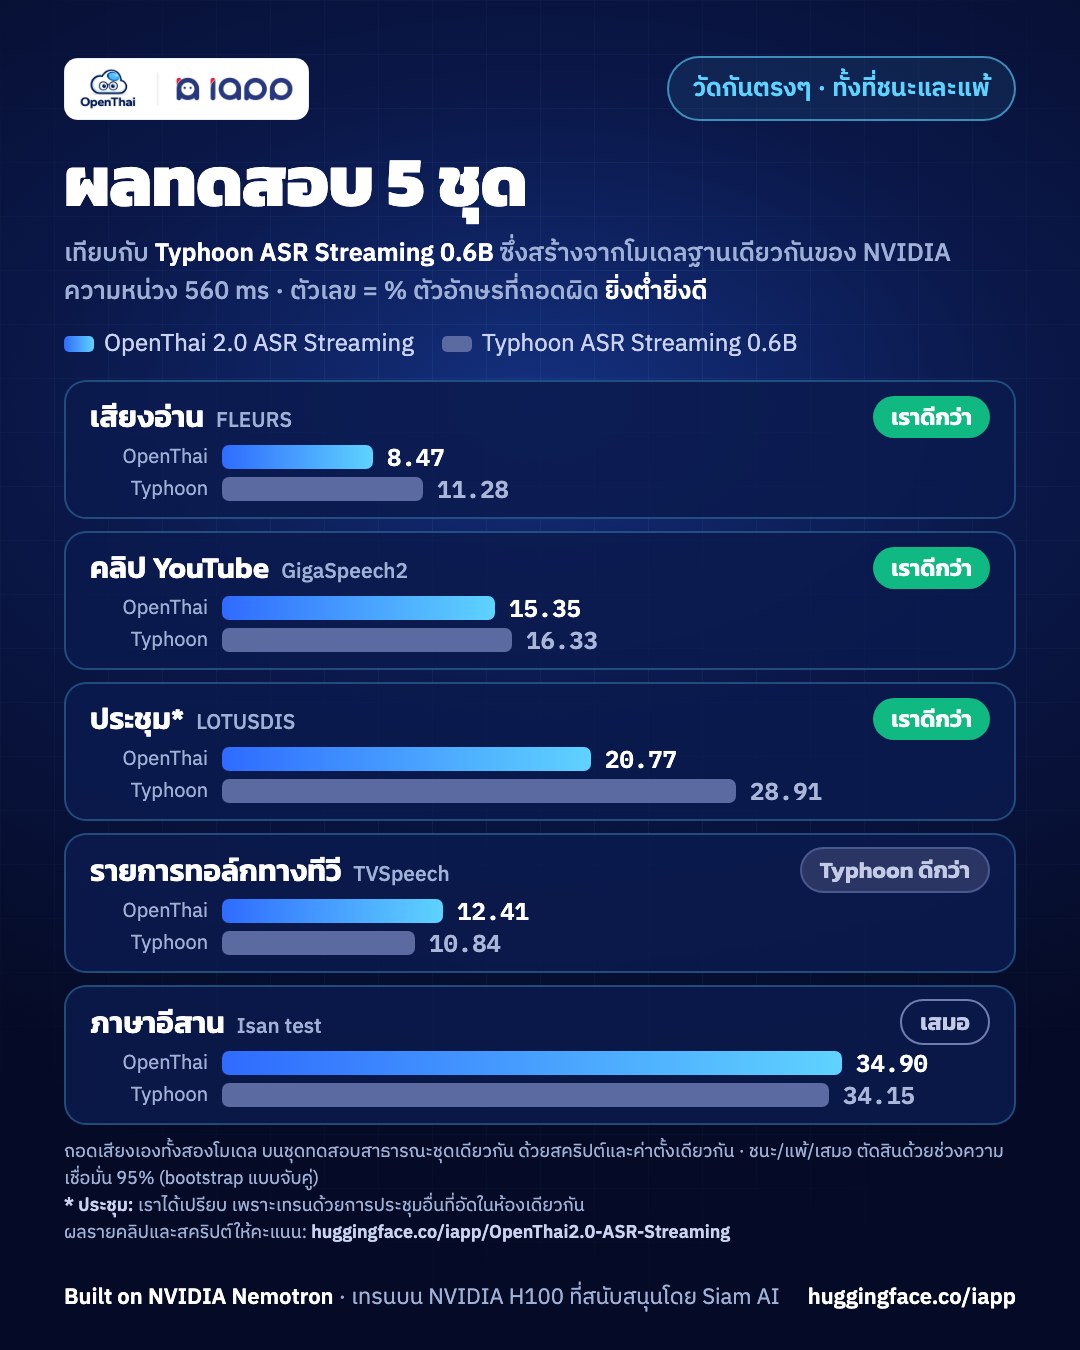
เราเปรียบเทียบกับโมเดลภาษาไทยแบบเปิดอีกตัวที่สร้างจากโมเดลฐานเดียวกันของ NVIDIA คือ Typhoon ASR Streaming 0.6B โดยถอดเสียงด้วยตัวเองทั้งสองโมเดล บนชุดทดสอบสาธารณะชุดเดียวกัน ด้วยสคริปต์และค่าตั้งเดียวกัน
อัตราผิดพลาดระดับตัวอักษร (%) ยิ่งต่ำยิ่งดี ที่ความหน่วง 560 ms เราถอดเสียงทุกโมเดลเองด้วยสคริปต์สตรีมมิงของ NeMo ชุดเดียวกันและค่าตั้งเดียวกัน ทั้ง Typhoon ASR Streaming 0.6B ตามที่เผยแพร่ และแบบที่ใช้โมเดลภาษา 4-gram ที่ผู้พัฒนาเผยแพร่คู่กัน
| ชุดทดสอบ | คลิป | OpenThai 2.0 ASR Streaming | Typhoon ASR Streaming 0.6B | Typhoon ASR Streaming 0.6B + โมเดลภาษา 4-gram | ผลต่าง ของเรา − Typhoon |
|---|---|---|---|---|---|
| FLEURS เสียงอ่าน | 1,021 | 8.47 | 11.28 | 11.73 | −2.82 [−3.15, −2.48], ของเราต่ำกว่า |
| GigaSpeech2 ชุดทดสอบ จาก YouTube | 8,823 | 15.35 | 16.33 | 16.62 | −0.98 [−1.31, −0.58], ของเราต่ำกว่า |
| TVSpeech รายการทีวีและ YouTube | 570 | 12.41 | 10.84 | 11.05 | +1.57 [+0.90, +2.52], Typhoon ต่ำกว่า |
| LOTUSDIS การประชุม ไมโครโฟนกลางโต๊ะ | 5,516 | 20.77 | 28.91 | 29.02 | −8.15 [−8.88, −7.46], ของเราต่ำกว่า |
| ภาษาถิ่นอีสาน | 500 | 34.90 | 34.15 | 35.79 | +0.75 [−0.21, +1.69], เสมอ |
- ก่อนให้คะแนน ข้อความทั้งสองฝั่งถูกเขียนให้อยู่ในรูปเดียวกัน คือทำตัวเลขให้ตรงกัน และตัดช่องว่างกับเครื่องหมายวรรคตอนออก ผลต่างคือของเราลบ Typhoon ASR Streaming 0.6B พร้อมช่วงความเชื่อมั่น 95% จาก paired bootstrap ที่สุ่มทั้งวิดีโอ ทั้งไฟล์บันทึก ทั้งผู้พูด หรือทั้งการประชุม ช่วงที่คร่อมศูนย์ถือว่าเสมอกัน ตัวหนาคือค่าผิดพลาดที่ต่ำกว่าอีกโมเดลด้วยความเชื่อมั่น 95%
- TVSpeech เป็นชุดทดสอบของ Typhoon ASR Streaming 0.6B เอง LOTUSDIS: เราเทรนด้วยการประชุมอื่นจากห้องและไมโครโฟนชุดเดียวกัน และผู้พูดบางคนอยู่ทั้งสองฝั่ง แถวนี้จึงได้เปรียบฝั่งเรา FLEURS: เราเทรนด้วยชุด train และ dev แต่ไม่ได้ใช้ชุด test ทั้งสองโมเดลเทรนด้วยชุด train ของ GigaSpeech2 เราไม่ได้เทรนด้วยภาษาอีสาน และข้อมูลเทรนที่ Typhoon ASR Streaming 0.6B เผยแพร่ก็ไม่มีภาษาอีสาน
- ไฟล์ที่เราเผยแพร่ตั้งค่า blank offset ไว้ที่ −1.0 ซึ่งเลือกจากข้อมูลชุดพัฒนา หากทำแบบเดียวกันกับ Typhoon ASR Streaming 0.6B ค่าที่ดีที่สุดบนข้อมูลชุดพัฒนาเดียวกันคือ -2.0 และค่าผิดพลาดจะเป็น FLEURS เสียงอ่าน 11.63, GigaSpeech2 ชุดทดสอบ จาก YouTube 15.26, TVSpeech รายการทีวีและ YouTube 10.68, LOTUSDIS การประชุม ไมโครโฟนกลางโต๊ะ 26.71, ภาษาถิ่นอีสาน 33.87
โมเดลนี้นำในเสียงอ่าน คลิปจาก YouTube และการประชุม (LOTUSDIS ได้เปรียบฝั่งเรา เพราะเราเทรนด้วยการประชุมอื่นจากห้องเดียวกัน) ส่วน Typhoon ASR Streaming 0.6B นำในรายการทอล์กทางทีวี ซึ่งเป็นชุดทดสอบ TVSpeech ของเขาเอง และทั้งสองเสมอกันในภาษาถิ่นอีสาน โมเดลภาษา 4-gram ของ Typhoon ASR Streaming 0.6B ช่วยให้เขียนคำภาษาอังกฤษถูกมากขึ้นตามที่การ์ดโมเดลระบุ แต่เพิ่มค่าผิดพลาดในทุกชุดทดสอบของเรา สำหรับไฟล์เสียงยาว ควรตัดเป็นท่อนตามช่วงหยุดก่อนถอด แบบที่เซิร์ฟเวอร์ที่แนบมาทำ วิธีนี้ทำให้ผลใกล้เคียงหรือดีกว่าการถอดทีละคลิป ส่วนการถอดต่อเนื่องในรอบเดียวทำให้โมเดลตกหล่นคำหลังช่วงที่เงียบ
ผลที่ 1120 มิลลิวินาทีและที่ทุกระดับความหน่วงอยู่ในหน้าโมเดล
เราสร้างอย่างไร
เราเริ่มจาก NVIDIA Nemotron 3.5 ASR Streaming 0.6B โมเดลสตรีมมิงหลายภาษาที่ก่อนปรับจูนถอดภาษาไทยผิดถึง 99% ของตัวอักษร เราขยาย tokenizer ด้วยหน่วยคำภาษาไทย 1,901 หน่วย เทรน decoder ใหม่บนคำศัพท์ชุดนั้น และปรับจูนทั้งโมเดลโดยเริ่มจาก encoder ของ NVIDIA
- ข้อมูล: เสียงพูดภาษาไทย 12,373 ชั่วโมง และภาษาอังกฤษ 961 ชั่วโมง ในส่วนภาษาไทย 10,400 ชั่วโมงเป็นเสียงจาก YouTube ในชุด train ของ GigaSpeech2 พร้อมคำถอดความอัตโนมัติของชุดนั้น อีก 1,973 ชั่วโมงถอดความโดยคน มาจากคลังข้อมูลภาษาไทยสาธารณะ และเสียงพอดแคสต์ รายการทอล์ก และไลฟ์สตรีมที่ iApp บันทึกเอง เราตัดเสียงภาษาโคราช คำเมือง และมลายูปัตตานีออก โมเดลนี้จึงเป็นโมเดลภาษาไทยกลาง
- การเทรน: 115,000 ขั้น เห็นเสียงรวมราว 30,700 ชั่วโมง บน GPU NVIDIA H100 ขั้นหลัง ๆ เพิ่มพรอมต์ภาษาที่สอง
th-mixซึ่งเขียนคำภาษาอังกฤษเป็นอักษรละติน และถ่วงน้ำหนักข้อมูลไปทางบทสนทนา - ตัดสินใจจากข้อมูลชุดพัฒนาเท่านั้น: ค่าตั้งทุกค่า รวมถึง blank offset ที่เก็บไว้ในไฟล์ที่เผยแพร่ เลือกจากข้อมูลชุดพัฒนา และไม่มีคลิปใดจากชุดทดสอบข้างต้นถูกใช้เทรน
ข้อจำกัด
โมเดลนี้รองรับภาษาไทยกลาง และกับภาษาถิ่นอีสานยังไม่ดีกว่า Typhoon ASR Streaming 0.6B คำภาษาอังกฤษจะออกมาเป็นอักษรไทย เว้นแต่จะเลือก th-mix และถึงอย่างนั้นก็เขียนเป็นอักษรละตินได้เพียงบางคำ เสียงลังเลและคำที่พูดซ้ำมักถูกตัดออก ความแม่นยำลดลงมากเมื่อไมโครโฟนอยู่ไกลจากผู้พูด ไฟล์เสียงยาวควรตัดเป็นท่อนตามช่วงหยุดก่อนถอด แบบที่เซิร์ฟเวอร์ที่แนบมาทำ และยังไม่ได้วัดกับเสียงโทรศัพท์ การ์ดโมเดลระบุข้อจำกัดทั้งหมดพร้อมตัวเลข
ดาวน์โหลด
น้ำหนักโมเดล การ์ดโมเดล และเซิร์ฟเวอร์ขนาดเล็กสำหรับไฟล์และการสตรีมสดอยู่บน Hugging Face และหน้าโมเดลมีคำสั่งให้ใช้ หากไม่ต้องการดูแล GPU เอง OpenThai ASR Realtime ให้บริการโมเดลนี้ผ่าน WebSocket API โดยไม่มีค่าใช้จ่ายในช่วงเปิดตัว และ Chinda ASR Pro v2 คือบริการที่แม่นกว่าของเราสำหรับไฟล์บันทึกเสียง
OpenThai 2.0 ASR Streaming เป็นงานดัดแปลงจาก NVIDIA Nemotron 3.5 ASR Streaming 0.6B และเผยแพร่ภายใต้ OpenMDW License Agreement เวอร์ชัน 1.1 Built on NVIDIA Nemotron. เทรนและทดสอบบน GPU NVIDIA H100 ที่สนับสนุนโดย Siam AI Corporation