OpenThai 2.1 OCR: อ่านภาพถ่ายเอกสารจากมือถือ สูตรคณิตศาสตร์เป็น LaTeX และแก้ไขตามเสียงผู้ใช้จริง

หกวันก่อนเราเปิดตัว OpenThai 2.0 OCR โมเดล OCR ภาษาไทยสองตัวที่ดาวน์โหลดได้ฟรี จากโครงการ OpenThai (เดิมคือ OpenThaiGPT) มีผู้นำไปใช้งานจริงทันที ทั้งเว็บที่อ่านเอกสารบนเบราว์เซอร์ แอปบน Windows และการทดสอบกับเอกสารราชการไทยเกือบพันหน้า ผู้ใช้ยังบอกเราทั้งในความคิดเห็นและในโค้ดของตัวเองว่าโมเดลอ่านผิดตรงไหน วันนี้เราเปิดตัว รุ่น 2.1 ของทั้งสองโมเดล และสิ่งที่เปลี่ยนไปส่วนใหญ่มาจากรายงานเหล่านั้น
OCR Markdown: huggingface.co/iapp/OpenThai2.1-OCR-Markdown-20261118 · OCR Text: huggingface.co/iapp/OpenThai2.1-OCR-Text-20261118 · GGUF สำหรับ llama.cpp: OpenThai2.1-OCR-Markdown-20261118-GGUF
OpenThai 2.1 OCR Markdown
OCR Markdown อ่านหน้าเอกสารทั้งหน้าออกมาเป็น Markdown โดยตารางทุกตารางยังเป็นตาราง HTML รุ่น 2.0 เทรนจากเอกสารราชการไทยเป็นหลัก รุ่น 2.1 เพิ่มภาพถ่ายเอกสารจากมือถือ ทั้งกระดาษโค้ง ยับ และมีเงา และเอกสารอีกเก้าประเภท ได้แก่ งานวิจัย หนังสือ การ์ตูน ข้อสอบ นิตยสาร หนังสือพิมพ์ รายงาน สไลด์ และตำราเรียน ทั้งภาษาไทยและอังกฤษ
ชุดทดสอบสาธารณะของภาพถ่ายจากโทรศัพท์และหน้าภาษาอังกฤษ รันด้วยสูตรการประเมินสาธารณะของ Typhoon OCR V2 2B และให้คะแนนด้วยตัวให้คะแนนของแต่ละชุดทดสอบ ตัวหนาคือคะแนนดีที่สุดของแต่ละคอลัมน์
| โมเดล | ขนาด | MDPBench ไทยและอังกฤษ | MDPBench ภาษาไทย | olmOCR-bench | OmniDocBench v1.6 |
|---|---|---|---|---|---|
| OpenThai 2.1 OCR Markdown | 0.63B | 82.5 | 80.7 | 73.1 | 79.6 |
| OpenThai 2.0 OCR Markdown | 0.63B | 73.7 | 72.7 | 50.9 | 61.8 |
| Nemotron 3.5 Parse (โมเดลฐาน) | 0.63B | 79.6 | 77.4 | 62.4 | 80.1 |
| Typhoon OCR V2 2B | 2B | 87.0 | 85.0 | 84.7 | 91.5 |
- MDPBench: หน้าภาษาไทยและอังกฤษ 320 หน้า สามในสี่เป็นภาพถ่ายจากโทรศัพท์ ไม่รวมคะแนนสูตรคณิตศาสตร์ ต่างจาก Typhoon OCR V2 2B −4.5 [−7.0, −2.0] และ −4.3 ในหน้าภาษาไทย [−8.4, −0.4] ช่องว่างมากที่สุดอยู่ที่ภาพถ่ายหน้าภาษาไทย (78.4 เทียบกับ 84.4) และตารางในภาพถ่ายเหล่านั้น ส่วนหน้าภาษาไทยที่เป็นไฟล์ดิจิทัลเสมอกัน (87.7 เทียบกับ 87.1)
- olmOCR-bench (หน้า PDF ภาษาอังกฤษ 1,403 หน้า) และ OmniDocBench v1.6 (หน้าภาษาอังกฤษและจีน 1,651 หน้า): ช่องว่างส่วนใหญ่จาก Typhoon OCR V2 2B อยู่ที่สูตรคณิตศาสตร์ ได้ 67.0 เทียบกับ 95.1 (formula CDM ของ OmniDocBench) ภาษาจีนไม่ใช่ภาษาเป้าหมายของโมเดลนี้
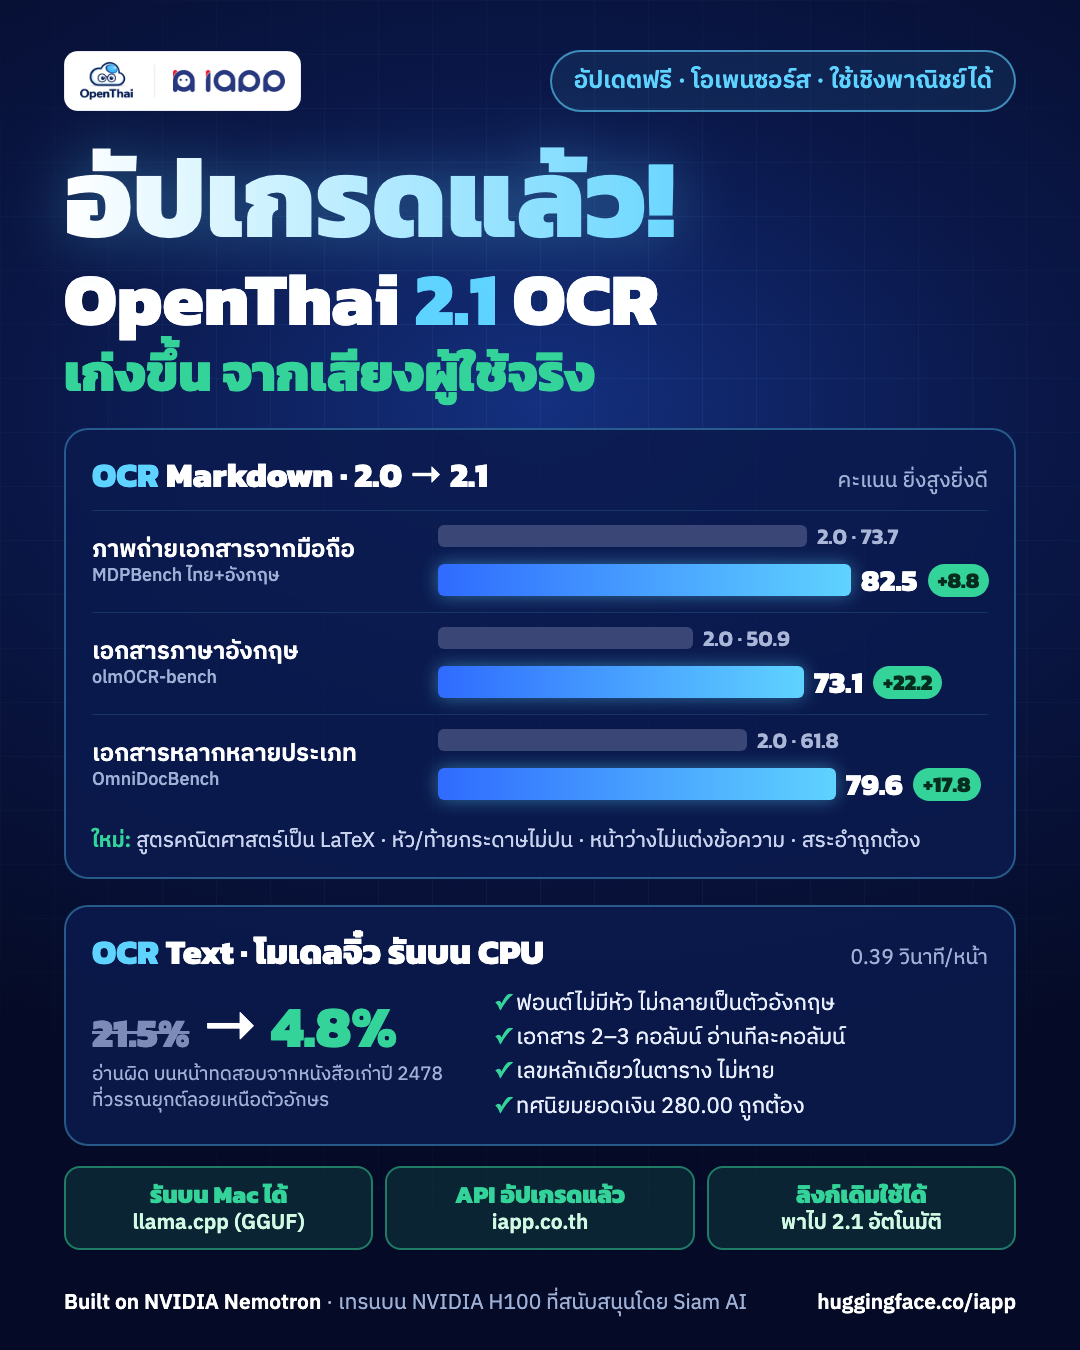
บนภาพถ่ายเอกสารจากมือถือ (MDPBench) คะแนนเพิ่มจาก 73.7 เป็น 82.5 และเฉพาะหน้าภาษาไทยจาก 72.7 เป็น 80.7 บนหน้า PDF ภาษาอังกฤษ (olmOCR-bench) เพิ่มจาก 50.9 เป็น 73.1
เอกสารราชการไทยยังอ่านได้เหมือนเดิม บนหน้าเอกสารของหน่วยงานรัฐและมหาวิทยาลัยไทยที่มีตาราง 65 หน้า ได้ 94.0 คะแนน (รุ่น 2.0: 95.2, [−2.9, +0.3] ต่างกันอย่างไม่มีนัยสำคัญ) และยังนำ Typhoon OCR V2 2B ที่ได้ 91.6 โมเดลมีขนาดเท่าเดิม 0.63 พันล้านพารามิเตอร์ และเร็วเท่าเดิม 1.5 วินาทีต่อหน้าบน NVIDIA H100 หนึ่งใบ
Markdown ที่ได้สะอาดขึ้น ซึ่งก็มาจากรายงานของผู้ใช้เช่นกัน:
- สูตรคณิตศาสตร์ ออกมาเป็น LaTeX ระหว่าง
$$ - หัวกระดาษและท้ายกระดาษ ไม่ปนอยู่ใน Markdown แต่ยังอยู่ในรายการบล็อกพร้อมกรอบตำแหน่ง
- หน้าว่าง ได้ผลลัพธ์ว่าง รุ่น 2.0 บางครั้งแต่งข้อความขึ้นมาบนกระดาษเปล่า
- สระอำ เขียนเป็นอักขระเดียว ข้อความภาษาไทยจึงตรงกับที่ระบบค้นหาและระบบตรวจตัวสะกดคาดหวัง และเซลล์ตารางไม่มี
rowspan="1"หรือcolspan="1"อีก
รันบน Mac หรือ CPU ได้แล้ว ด้วย llama.cpp
รุ่น 2.0 ต้องใช้ vLLM ซึ่งรันบน Linux หากไม่มี vLLM ผู้ใช้รายงานว่าใช้เวลา 5 ถึง 11 วินาทีต่อหน้าบน GPU ของโน้ตบุ๊ก และหนึ่งถึงสองนาทีบน CPU รุ่น 2.1 จึงมีไฟล์ GGUF สำหรับ llama.cpp ด้วย รันได้บน Mac บน CPU หรือบน GPU ทั่วไป โดยไม่ต้องมี PyTorch หรือ vLLM โมเดลนี้ยังไม่อยู่ใน llama.cpp ต้นฉบับ เราจึงเผยแพร่ fork ของเรา: iapp-technology/llama.cpp branch nemotron-parse
Markdown จากรุ่น GGUF ตรงกับโมเดลต้นฉบับ 30 จาก 30 หน้าทดสอบ บน Apple M3 Max ใช้เวลา 4.8–7.0 วินาทีต่อหน้าด้วย Metal และราว 58 วินาทีเมื่อใช้ CPU อย่างเดียว คำสั่งทั้งหมดอยู่ที่รีโพ GGUF และในคู่มือสำหรับ Windows, Mac และ Linux
API รันรุ่น 2.1 แล้ว
OpenThai 2.1 OCR Markdown API รันรุ่น 2.1 ตั้งแต่เวลา 08:33 น. ของวันที่ 18 พฤศจิกายน 2569 โดยใช้ endpoint และราคาเดิม หน้าละ 0.15 IC หากคุณใช้งานอยู่ Markdown ที่ได้จะเปลี่ยนไปสี่อย่าง: หัวกระดาษและท้ายกระดาษไม่อยู่ใน Markdown แล้ว (ยังอยู่ใน blocks) สูตรคณิตศาสตร์ออกมาเป็น $$...$$ หน้าว่างได้ผลลัพธ์ว่าง และสระอำเป็นอักขระเดียว
OpenThai 2.1 OCR Text
OCR Text คือโมเดลตัวเล็ก ไฟล์สามไฟล์รวม 6.6 MB อ่านหนึ่งหน้าใน 0.39 วินาทีบน CPU โดยไม่ต้องใช้ GPU หรืออินเทอร์เน็ต รุ่น 2.1.4 ใช้ไฟล์โมเดลเดิมของรุ่น 2.0 กับรันไทม์ใหม่และตัวอ่านบรรทัดตัวที่สอง สิ่งที่แก้ไข:
- หนังสือเก่าที่วรรณยุกต์ลอยเหนือบรรทัด บนหน้าทดสอบจากหนังสือที่พิมพ์ปี 2478 อัตราอ่านผิดลดจาก 21.5% เหลือ 4.8%
- ฟอนต์ไม่มีหัว เช่น Kanit, Prompt และ Sukhumvit Set ไม่กลายเป็นตัวอังกฤษอีก บน 12 หน้าทดสอบในฟอนต์ที่โมเดลไม่เคยเห็น ตัวอังกฤษที่หลุดเข้ามาลดจาก 58 เหลือ 11 ตัว
- หน้าสองและสามคอลัมน์ อ่านทีละคอลัมน์ และรายการคงลำดับแถว
- เซลล์ตารางที่มีอักขระเดียว: จำนวน "2" หรือรหัสวัน M, T, W ที่อยู่เดี่ยวในเซลล์ไม่หายไป และยอดเงินอย่าง "280,00" ออกมาเป็น "280.00"
- ใช้หน่วยความจำน้อยลง บน Mac และ Windows และมี
requirements.txtที่ระบุรุ่นแพ็กเกจที่ทดสอบแล้ว
บนชุดทดสอบตัวพิมพ์ 12 ชุด ค่าเฉลี่ยเพิ่มจาก 87.8 เป็น 88.3 และบนหน้าเต็มของ ThaiOCRBench จาก 82.0 เป็น 84.1 การแก้ไขเกือบทุกข้อข้างต้นเริ่มจากรายงานของผู้ใช้ ทั้งความคิดเห็นในโพสต์ Facebook ของเรา และวิธีแก้ปัญหาในโปรเจกต์บน GitHub ที่สร้างบนโมเดลนี้
OpenThai 2.1 OCR Text API รันรุ่น 2.1.2 ตั้งแต่ 16 พฤศจิกายน 2569 ซึ่งรวมการแก้ไขเรื่องวรรณยุกต์ คอลัมน์ และฟอนต์ไม่มีหัว ส่วนเรื่องเซลล์อักขระเดียวและจุดทศนิยมของรุ่น 2.1.4 มีในไฟล์ที่ดาวน์โหลด
สิ่งที่ยังตามหลัง
บนภาพถ่ายเอกสาร หน้าภาษาอังกฤษ และสูตรคณิตศาสตร์ Typhoon OCR V2 2B ยังนำ OCR Markdown อยู่: 87.0 บน MDPBench เทียบกับ 82.5 ของเรา 84.7 บน olmOCR-bench เทียบกับ 73.1 และ 91.5 บน OmniDocBench เทียบกับ 79.6 ช่องว่างที่กว้างที่สุดคือสูตรคณิตศาสตร์: 67.0 เทียบกับ 95.1 บนคะแนนสูตรของ OmniDocBench สำหรับรุ่นถัดไป เรากำลังเก็บภาพถ่ายเอกสารภาษาไทยจริงและข้อมูลสูตรคณิตศาสตร์เพิ่มเติม
อัปเกรดจากรุ่น 2.0
ทั้งสองรีโพมีวันที่เผยแพร่อยู่ในชื่อแล้ว ชื่อเดิม iapp/OpenThai2.0-OCR-Markdown และ iapp/OpenThai2.0-OCR-Text พาไปยังรีโพใหม่โดยอัตโนมัติ ลิงก์และโค้ดเดิมจึงยังใช้ได้และจะได้รุ่น 2.1
hf download iapp/OpenThai2.1-OCR-Markdown-20261118 --local-dir OpenThai2.1-OCR-Markdown
hf download iapp/OpenThai2.1-OCR-Text-20261118 --local-dir OpenThai2.1-OCR-Text
ถ้าต้องการคงรุ่นไว้ ให้ระบุรุ่น: --revision v2.1.0 สำหรับ OCR Markdown 2.1 หรือ --revision v2.1.4 สำหรับ OCR Text 2.1.4 และ --revision v2.0.0 สำหรับรุ่น 2.0 ของทั้งสองโมเดล ใน Python ใส่ค่าเดียวกันเป็น revision= ของ snapshot_download ถ้าต้องการ Markdown แบบรุ่น 2.0 จากโมเดลรุ่น 2.1 (เก็บหัวกระดาษ และสูตรเป็น \(...\)) ดูได้ที่หน้าโมเดล
ลิงก์
- หน้าโมเดล: OpenThai 2.1 OCR Markdown และ OpenThai 2.1 OCR Text พร้อมผลทดสอบทุกชุด
- คู่มือ: วิธีรัน OpenThai OCR บน Windows, Mac และ Linux
- API: OCR Markdown หน้าละ 0.15 IC และ OCR Text เริ่มต้นหน้าละ 0.049 IC
- การเปิดตัวรุ่น 2.0: OpenThai 2.0 OCR Markdown
ขอบคุณทุกคนที่ลองใช้รุ่น 2.0 และบอกเราว่าโมเดลอ่านผิดตรงไหนครับ หากเอกสารใดยังอ่านได้ไม่ดี ส่งตัวอย่างที่ไม่มีข้อมูลส่วนบุคคลมาที่ sale@iapp.co.th
Built on NVIDIA Nemotron. OCR Markdown คือโมเดลที่ปรับจูนภาษาไทยจาก NVIDIA Nemotron 3.5 Parse ภายใต้สัญญาอนุญาต OpenMDW-1.1 ส่วน OCR Text ใช้สัญญาอนุญาต Apache-2.0 พัฒนาโดย iApp เปิดตัวร่วมกับ AIEAT เทรนบน GPU NVIDIA H100 ที่สนับสนุนโดย Siam AI Corporation