OpenThai 2.0 OCR Markdown: โมเดลแบบเปิดที่อ่านเอกสารไทยเป็น Markdown พร้อมตาราง

วันนี้เราเปิดตัว OpenThai 2.0 OCR Markdown โมเดลแบบเปิดน้ำหนักที่อ่านหน้าเอกสารภาษาไทยและอังกฤษออกมาเป็น Markdown โดยเขียนตารางทุกตารางเป็น HTML ขนาด 0.63 พันล้านพารามิเตอร์ อ่านหนึ่งหน้าใน 1.6 วินาทีบน NVIDIA H100 หนึ่งใบ และดาวน์โหลดได้ฟรีจาก Hugging Face ภายใต้สัญญาอนุญาต OpenMDW-1.1 โมเดลเดียวกันนี้ยังใช้ผ่าน API ได้ หน้าละ 0.15 IC
หน้าโมเดล: iapp.co.th/openmodels/openthai2p0-ocr-markdown · น้ำหนักโมเดล: huggingface.co/iapp/OpenThai2.0-OCR-Markdown
ทำไมต้องเป็นตาราง
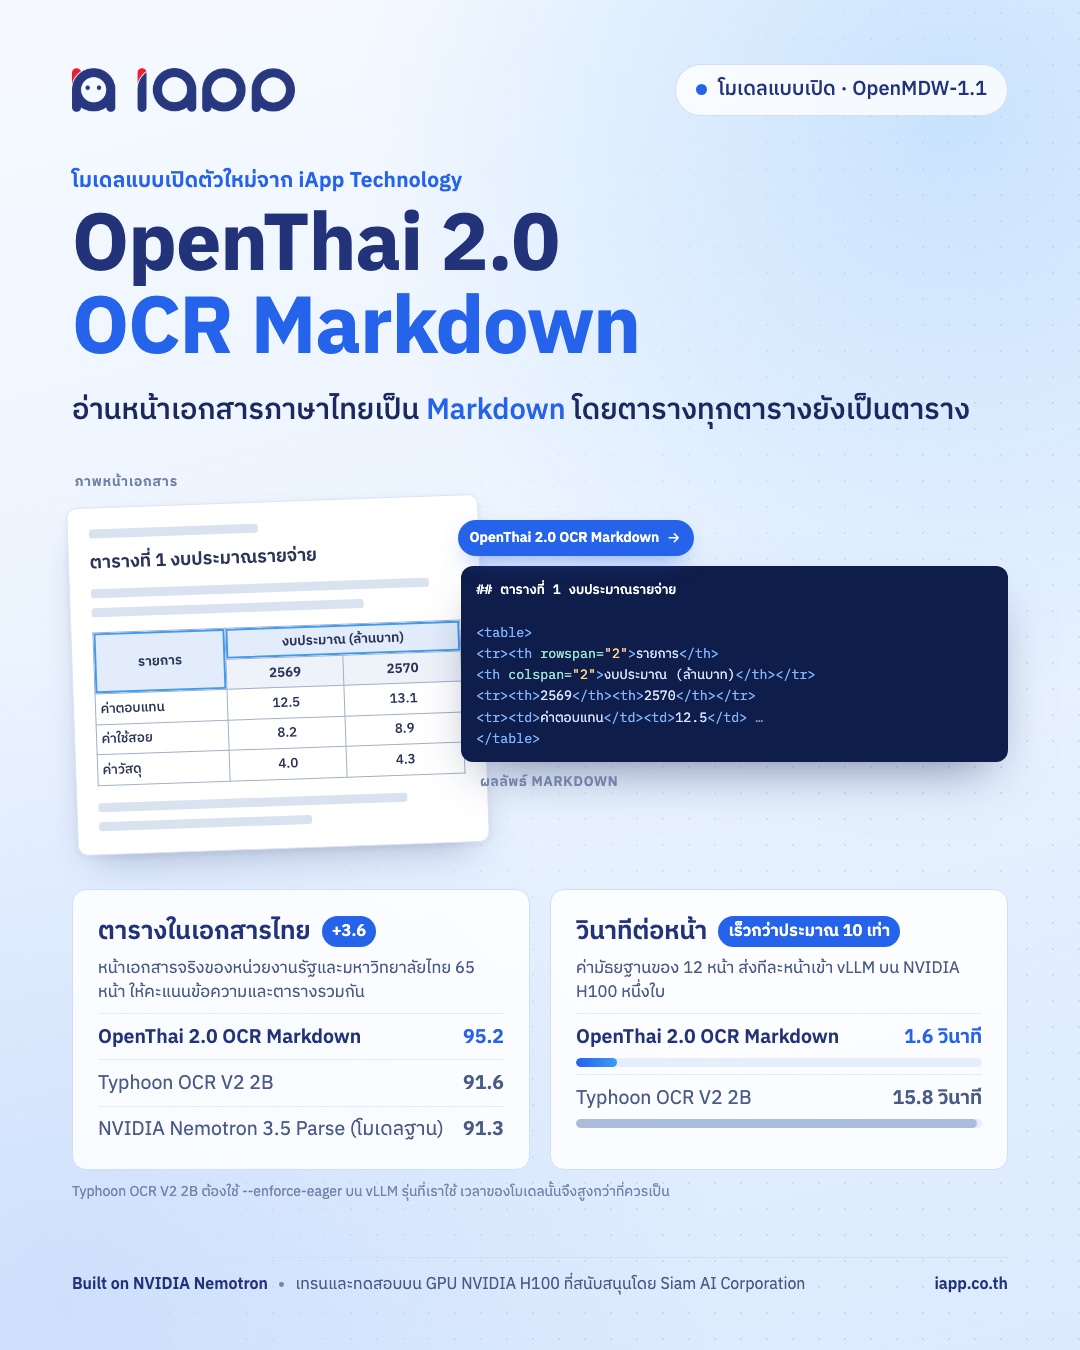
เอกสารของหน่วยงานรัฐและมหาวิทยาลัยไทยเต็มไปด้วยตาราง ทั้งรายละเอียดงบประมาณ ตารางเวลา และแบบฟอร์มที่หัวตารางผสานหลายแถวหลายคอลัมน์ OCR ที่คืนค่าเป็นบรรทัดข้อความทำให้ไม่รู้ว่าตัวเลขใดอยู่แถวและคอลัมน์ใด OpenThai 2.0 OCR Markdown เขียนแต่ละตารางเป็น HTML พร้อม rowspan และ colspan โครงสร้างนั้นจึงไปถึงระบบค้นหาหรือโมเดลภาษาของคุณครบถ้วน ส่วนที่อยู่รอบตารางเขียนเป็นหัวข้อ รายการ และย่อหน้าแบบ Markdown และทุกบล็อกมีกรอบตำแหน่งและประเภท เรียงตามลำดับการอ่าน
ผลการทดสอบ
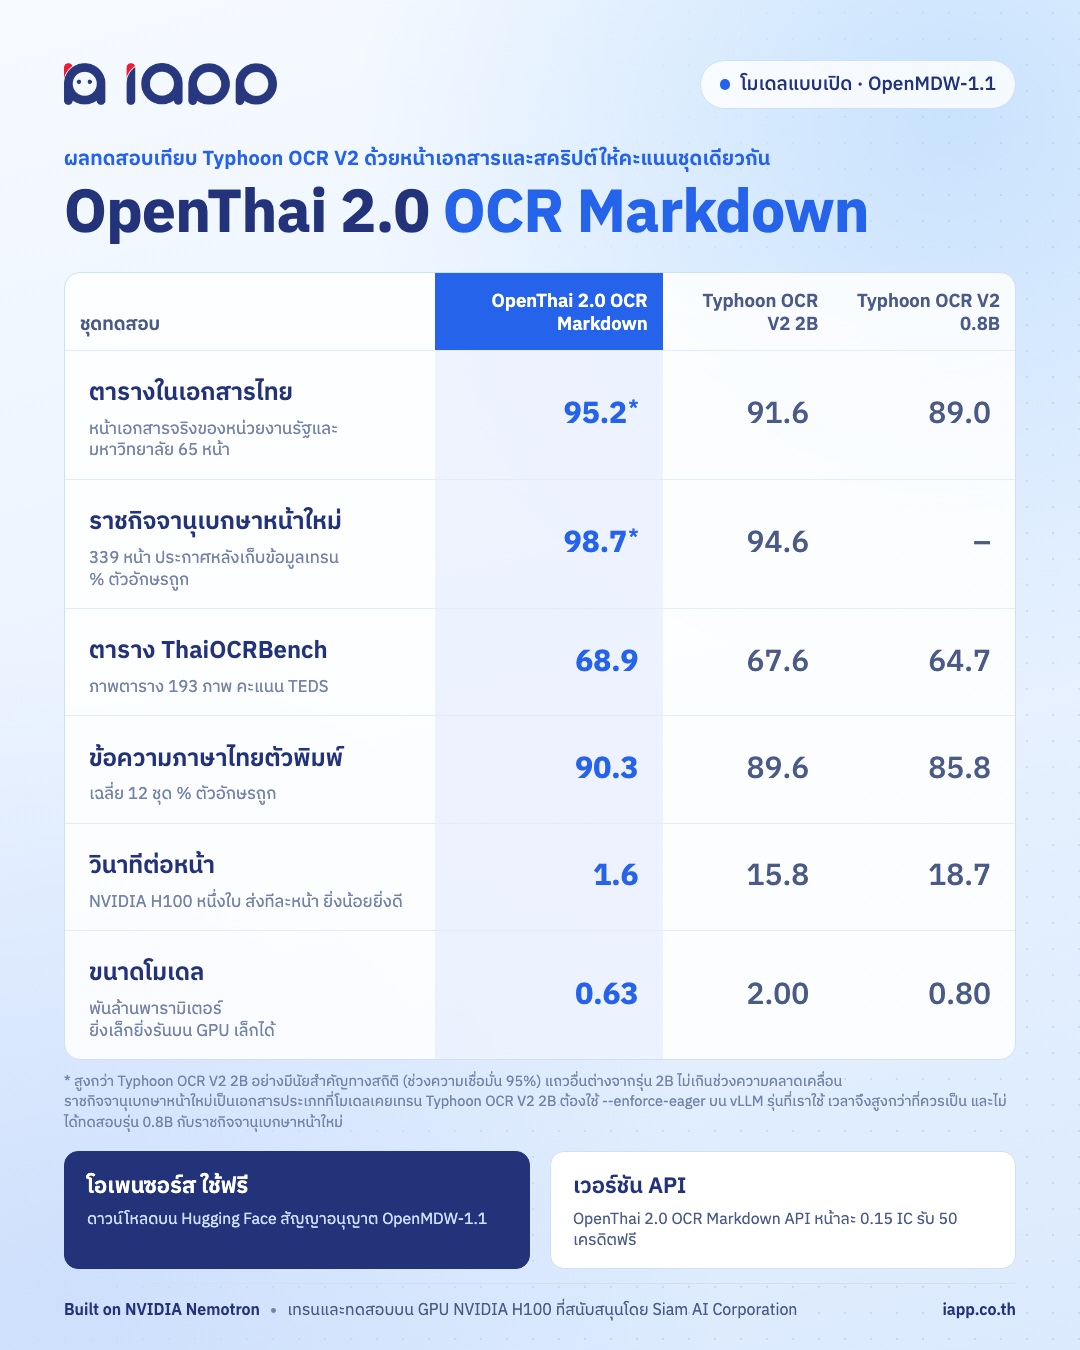
ทุกโมเดลอ่านหน้าเดียวกันและให้คะแนนด้วยสคริปต์เดียวกัน Typhoon OCR V2 2B และ Typhoon OCR V2 0.8B ใช้ค่าตั้งตามการ์ดโมเดลของตน ช่วงความเชื่อมั่นเป็นช่วง 95% จาก paired bootstrap รายหน้า
| โมเดล | ขนาด | ตารางในเอกสารไทย | ตาราง ThaiOCRBench | ข้อความไทยตัวพิมพ์ | วินาทีต่อหน้า | ราชกิจจานุเบกษาชุดใหม่ |
|---|---|---|---|---|---|---|
| OpenThai 2.0 OCR Markdown | 0.63B | 95.2 | 68.9 | 90.3 | 1.6 | 98.7 |
| Nemotron 3.5 Parse (โมเดลฐาน) | 0.63B | 91.3 | 68.3 | 89.0 | 1.8 | 91.5 |
| Typhoon OCR V2 2B | 2B | 91.6 | 67.6 | 89.6 | 15.8 | 94.6 |
| Typhoon OCR V2 0.8B | 0.8B | 89.0 | 64.7 | 85.8 | 18.7 | – |
- ตารางในเอกสารไทย: หน้าเอกสารจริงของหน่วยงานรัฐและมหาวิทยาลัยไทย 65 หน้า ให้คะแนนข้อความและตารางรวมกัน สูงกว่า Typhoon OCR V2 2B 3.6 คะแนน ช่วงความเชื่อมั่น 95% [+1.2, +6.2] และสูงกว่าโมเดลฐาน 3.9 คะแนน
- ตาราง ThaiOCRBench: คะแนนโครงสร้างและเนื้อหาตาราง (TEDS) บนภาพตาราง 193 ภาพ ต่างจาก Typhoon OCR V2 2B +1.3 [−1.7, +4.6] ถือว่าเสมอกัน
- ข้อความไทยตัวพิมพ์: ความแม่นยำระดับตัวอักษร 100 × (1 − อัตราผิดพลาดระดับตัวอักษร) เฉลี่ย 12 ชุด รวม 1,200 หน้าและคำพิพากษาศาลปกครองฉบับเต็ม 50 ฉบับ ต่างจาก Typhoon OCR V2 2B +0.76 [−0.04, +1.51] ถือว่าเสมอกัน หน้าที่ถูกตัดเพราะวนซ้ำนับเป็นหน้าว่าง และไม่มีหน้าใดใน 2,270 หน้าถูกตัด
- วินาทีต่อหน้า: ค่ามัธยฐานของ 12 หน้าที่ส่งทีละหน้าเข้า vLLM บน NVIDIA H100 หนึ่งใบ Typhoon OCR V2 2B ต้องใช้
--enforce-eagerบน vLLM รุ่นที่เราใช้ เวลาของโมเดลนั้นจึงสูงกว่าที่ควรเป็น - ราชกิจจานุเบกษาชุดใหม่: 339 หน้าจาก 293 ฉบับที่ประกาศในวันที่ 4–9 พฤศจิกายน 2569 หลังจากที่เราเก็บข้อมูลเทรนเสร็จแล้ว ชุดนี้ถูกล็อกไว้ก่อนที่โมเดลใดจะอ่าน และทุกโมเดลอ่านแต่ละหน้าเพียงครั้งเดียว วัดความแม่นยำระดับตัวอักษร เอกสารเหล่านี้เป็นเอกสารใหม่ แต่เป็นประเภทที่ OpenThai 2.0 OCR Markdown เคยเทรน (ราชกิจจานุเบกษาของเดือนก่อน ๆ) ผลนี้จึงบอกว่าโมเดลอ่านเอกสารที่ไม่เคยเห็นได้ดีเพียงใด ไม่ใช่เอกสารประเภทใหม่ ข้อความอ้างอิงสร้างด้วยเครื่องมือเดียวกับที่สร้างป้ายกำกับราชกิจจานุเบกษาในข้อมูลเทรนของเรา จึงเป็นไปตามรูปแบบที่โมเดลนี้เรียนรู้มา ต่างจาก Typhoon OCR V2 2B +4.1 [+3.7, +4.4] และเมื่อตัดช่องว่างทั้งหมดออกเพื่อไม่ให้วิธีต่อบรรทัดมีผล ต่าง +3.5 [+3.2, +3.9] ไม่ได้ทดสอบ Typhoon OCR V2 0.8B กับชุดนี้
ในตารางเอกสารไทย โมเดลนี้ดีกว่า Typhoon OCR V2 2B อย่างมีนัยสำคัญ ส่วนตาราง ThaiOCRBench และข้อความตัวพิมพ์ทั้งสองใกล้เคียงกัน และเร็วกว่าราว 10 เท่าด้วยขนาดราวหนึ่งในสาม บนหน้าราชกิจจานุเบกษาใหม่ 339 หน้าที่ประกาศหลังจากเราเก็บข้อมูลเทรนเสร็จ อ่านตัวอักษรถูก 98.7% เทียบกับ 94.6% ของ Typhoon OCR V2 2B ซึ่งดีกว่าอย่างมีนัยสำคัญเช่นกัน ทั้งนี้เป็นเอกสารใหม่ แต่เป็นประเภทที่โมเดลเคยเทรน ผลรายชุดของข้อความตัวพิมพ์ทั้ง 12 ชุดอยู่ในหน้าโมเดล
เราสร้างโมเดลนี้อย่างไร
เราเริ่มจาก NVIDIA Nemotron 3.5 Parse โมเดลขนาด 0.63B ที่อ่านเลย์เอาต์ ประเภทบล็อก และลำดับการอ่านได้อยู่แล้ว แล้วปรับจูนสำหรับภาษาไทย ชุดเครื่องมือสำหรับรันและจัดผลลัพธ์ยังเป็นของเดิม OpenThai 2.0 OCR Markdown จึงรันได้ทุกที่ที่โมเดลฐานรันได้
ป้ายกำกับข้อความเป็นข้อความที่ถูกต้องแน่นอน ไม่ใช่ผลอ่านของโมเดลอื่น ชุดข้อมูลเทรนมี 54,596 แถว:
- เอกสารภาษาไทยสังเคราะห์ เรนเดอร์ในเบราว์เซอร์จากข้อความ Wikipedia ภาษาไทยด้วยฟอนต์สัญญาอนุญาตเปิด 24 แบบ ได้แก่ แบบฟอร์ม บันทึกข้อความ รายงานการประชุม ตารางเวลา และตารางผสานเซลล์ พร้อมร่องรอยการสแกนและการถ่ายด้วยโทรศัพท์ หน้าสองและสามคอลัมน์สอนให้อ่านทีละคอลัมน์
- หน้าเอกสารราชการไทยที่สร้างจากไฟล์ดิจิทัล ได้แก่ เอกสารงบประมาณของรัฐสภาและราชกิจจานุเบกษา ซึ่งชั้นข้อความใน PDF ให้ข้อความที่ถูกต้องแน่นอน และเส้นตารางให้โครงสร้างตารางที่ถูกต้องแน่นอน
- ตารางแบบอื่น ได้แก่ ตารางการเงินและตารางงานวิจัยจากชุดข้อมูลสาธารณะ FinTabNet และ PubTabNet และใบเสร็จ ใบแจ้งยอด ผลตรวจแล็บ เอกสารประกัน และตารางที่มีหัวแถวหลายชั้นภาษาไทยแบบสังเคราะห์ บางส่วนใช้เลขไทยทั้งหมด
- ภาพตัดสั้น ของบรรทัดลายมือ ข้อความภาษาอังกฤษ และตัวพิมพ์ดอตเมทริกซ์ที่สร้างขึ้น เพื่อให้ยังอ่านข้อความชิ้นสั้นได้
- หน้าที่เคยวนซ้ำ 420 หน้า จากภาพสแกนหนังสือเก่า ภาพถ่ายใบเสร็จสังเคราะห์ และหน้าเอกสารราชการ ซึ่งโมเดลที่ปรับจูนรอบก่อน ๆ เคยวนซ้ำ แต่ละหน้าใช้ผลอ่านของโมเดลรุ่นนั้นจนถึงจุดที่เริ่มวนซ้ำ และการเทรนลดโอกาสที่โมเดลจะเขียนส่วนที่วนซ้ำนั้นอีก
เราเทรนบน H100 หนึ่งใบหนึ่งรอบ 1,707 ขั้น รุ่นที่เผยแพร่คือ checkpoint สุดท้ายตามที่เทรนมา โดยไม่ผสมน้ำหนักของโมเดลฐาน
checkpoint นี้เลือกด้วยกฎที่กำหนดไว้ก่อนให้คะแนนโมเดลใด ๆ โดยใช้ชุดพัฒนาเท่านั้น ไม่มีผลทดสอบข้างต้นใดถูกใช้ในการเลือก การ์ดโมเดลอธิบายกฎนี้ ไม่มีหน้าใดจากชุดทดสอบถูกใช้เทรน
ข้อจำกัด
- ไม่มีหน้าใดวนซ้ำในการทดสอบของเรา ทั้งหน้าข้อความตัวพิมพ์ 2,270 หน้า ภาพตาราง ThaiOCRBench 193 ภาพ และหน้าชุดพัฒนา 6,137 หน้า หากหน้าใดวนซ้ำ ตัวอ่านจะแจ้งข้อผิดพลาด จึงส่งหน้านั้นต่อให้ตัวอ่านอื่นได้
- ภาพถ่ายคำเดี่ยวและภาพตัดสั้นมากอ่านได้แย่กว่าหน้าเต็ม: 96.4 เทียบกับ 99.8 ของ Typhoon OCR V2 2B
- ตัวพิมพ์ดอตเมทริกซ์ เช่น สมุดบัญชีธนาคารและแบบฟอร์มที่พิมพ์ด้วยเครื่องพิมพ์หัวเข็ม อ่านได้ไม่ดีเท่าตัวพิมพ์ทั่วไป: ความแม่นยำระดับตัวอักษรราว 89% บนภาพตัดชุดพัฒนาของเรา ภาพตัดเหล่านี้สร้างขึ้นเอง และยังไม่มีชุดทดสอบจากเอกสารดอตเมทริกซ์จริง จึงควรคาดว่าสมุดบัญชีจริงจะได้ผลต่ำกว่านี้
- หน้าลายมือทั้งหน้า ข้อความในภาพถ่ายฉาก และภาพถ่ายหน้าจอ ไม่ใช่เป้าหมาย
ดาวน์โหลด
น้ำหนักโมเดล การ์ดโมเดล และแพ็กเกจ nemotron_parse ของ NVIDIA อยู่บน Hugging Face ดาวน์โหลดได้ฟรี และหน้าโมเดลมีคำสั่งสำหรับรันด้วย vLLM และอ่านหนึ่งหน้า หากไม่ต้องการดูแล GPU เอง OpenThai 2.0 OCR Markdown API รันโมเดลเดียวกันนี้ให้ในประเทศไทย หน้าละ 0.15 IC
OpenThai 2.0 OCR Markdown เป็นงานดัดแปลงจาก NVIDIA Nemotron 3.5 Parse และเผยแพร่ภายใต้ OpenMDW License Agreement เวอร์ชัน 1.1 Built on NVIDIA Nemotron. เทรนและทดสอบบน GPU NVIDIA H100 ที่สนับสนุนโดย Siam AI Corporation