OpenThai 2.0 OCR Text: โมเดล OCR ภาษาไทยฟรีที่รันบน CPU ทั่วไป

OpenThai 2.1 OCR Text ออกแล้ว ใช้ไฟล์โมเดลชุดเดียวกับที่บทความนี้อธิบาย และเพิ่มรันไทม์ใหม่กับตัวอ่านบรรทัดตัวที่สอง จึงคงวรรณยุกต์ของหนังสือเก่า อ่านฟอนต์ไม่มีหัวอย่าง Kanit และ Prompt ได้ และเก็บช่องตารางที่มีตัวอักษรตัวเดียวไว้ บทความนี้อธิบายรุ่น 2.0 ซึ่งยังดาวน์โหลดได้ที่แท็ก v2.0.0 ลิงก์ดาวน์โหลดด้านล่างตอนนี้พาไปที่รุ่น 2.1
วันนี้เราเปิดตัว OpenThai 2.0 OCR Text โมเดลจาก OpenThai (เดิมคือ OpenThaiGPT) ที่อ่านข้อความภาษาไทยและอังกฤษตัวพิมพ์จากภาพสแกนและภาพหน้าเอกสาร โมเดลมีขนาดเล็ก 1.02 ล้านพารามิเตอร์ ในไฟล์สองไฟล์รวม 4.2 MB อ่านหน้า A4 ที่ข้อความแน่นได้ใน 0.39 วินาทีบน CPU ทั่วไป ไม่ต้องใช้ GPU และไม่ต้องต่ออินเทอร์เน็ต เอกสารจึงไม่ต้องออกจากเครื่องที่อ่าน ดาวน์โหลดได้ฟรีจาก Hugging Face ภายใต้สัญญาอนุญาต Apache-2.0 และเป็นเอนจินเดียวกับที่อยู่เบื้องหลัง OCR Text API ของ iApp
หน้าโมเดล: iapp.co.th/openmodels/openthai2p0-ocr-text · น้ำหนักโมเดล: huggingface.co/iapp/OpenThai2.1-OCR-Text-20261118
ทำอะไรได้บ้าง
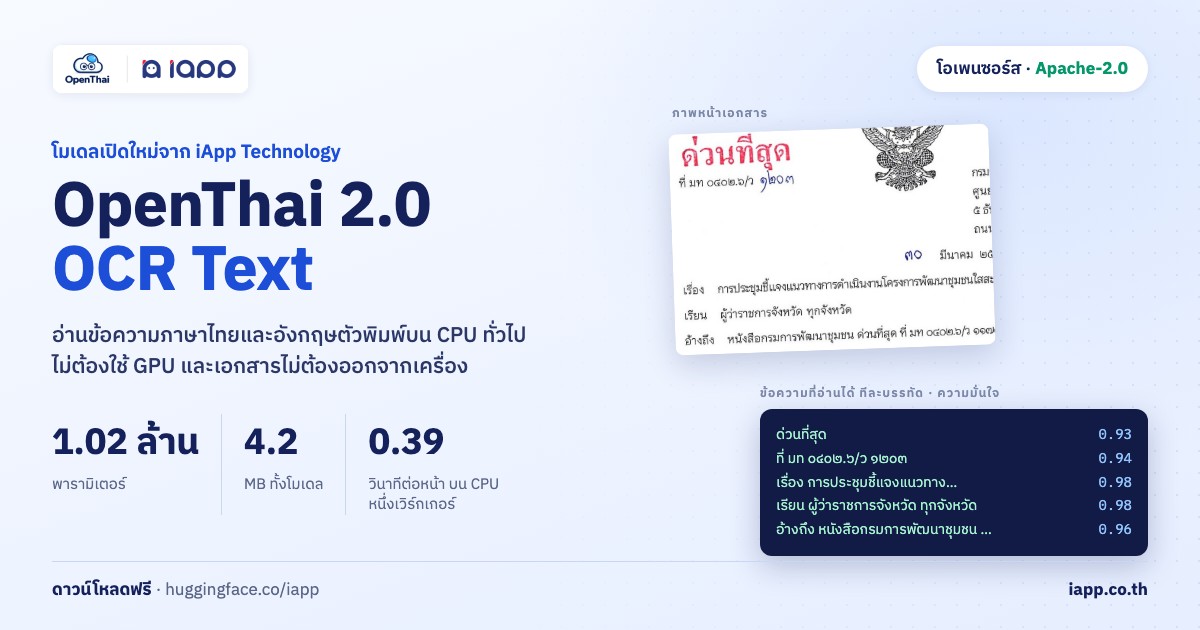
ส่งภาพหน้าเอกสารเข้าไป โมเดลจะคืนข้อความของหน้าตามลำดับการอ่าน ทุกบรรทัดมีกรอบตำแหน่งในพิกัดของภาพที่ส่งเข้าไป และค่าความมั่นใจระหว่าง 0 ถึง 1 จึงส่งบรรทัดที่ไม่แน่ใจให้คนตรวจต่อได้
ก่อนอ่าน โมเดลเตรียมหน้าเอกสารให้พร้อมแบบที่ภาพสแกนจริงต้องการ
- ทิศทาง: หน้าที่ตะแคงหรือกลับหัวจะถูกหมุนไปทางที่บรรทัดอ่านได้ดีที่สุด
- ความเอียง: ภาพสแกนที่เอียงเกิน 2.5 องศาจะถูกปรับให้ตรง และกรอบตำแหน่งคืนมาในพิกัดของภาพต้นฉบับ
- ลำดับการอ่าน: หน้าสองและสามคอลัมน์อ่านทีละคอลัมน์ ตาราง เอกสารงบประมาณ และรายการคงลำดับแถวไว้
- สี: หักสีพื้นหลังของแต่ละคอลัมน์ออก จึงอ่านตัวอักษรสีอ่อนบนพื้นเข้ม สไลด์สี และพื้นไล่สีได้
ผ่านครบทั้ง 22 เงื่อนไขในชุดทดสอบความทนทาน (การหมุน ความเอียง ตัวอักษรใหญ่มากและเล็กมาก สี งานพิมพ์ซีด สัญญาณรบกวนจากการถ่ายเอกสาร ภาพถ่ายจากมือถือ ตาราง และคอลัมน์) เงื่อนไขละ 20 หน้าที่กันไว้ไม่ใช้เทรน โดยกำหนดเกณฑ์ผ่านไว้ก่อนรันครั้งแรก
โมเดลนี้เขียนข้อความ ไม่เขียนตาราง ถ้าต้องการให้ตารางยังเป็นตาราง ให้ใช้ OpenThai 2.0 OCR Markdown ที่เปิดตัววันเดียวกัน
ทำไมต้องเป็นโมเดลเล็ก
หลายองค์กรส่งเอกสารออกไปให้บริการภายนอกไม่ได้ เช่น หน่วยงานรัฐ โรงพยาบาล ธนาคาร และสำนักงานกฎหมาย โมเดลที่รันบน CPU ของเครื่องที่เก็บเอกสารอยู่จึงอ่านเอกสารได้ในที่ที่มันอยู่ โปรเซสที่อ่านเอกสารใช้ 0.5 วินาที CPU และหน่วยความจำราว 450 MB ต่อหน้า เซิร์ฟเวอร์ 8 คอร์หนึ่งเครื่องจึงอ่านได้ราว 950 หน้าต่อนาที หนึ่งล้านหน้าใช้เวลาไม่ถึงหนึ่งวัน โดยไม่ต้องใช้ GPU
ผลการทดสอบ
การ์ดโมเดลทดสอบเอนจิน OCR 15 ตัวบนหน้าเดียวกันและให้คะแนนแบบเดียวกัน คือความแม่นยำระดับตัวอักษร 100 × (1 − อัตราตัวอักษรผิด) ยิ่งสูงยิ่งดี หลังตัดมาร์กอัปออกทั้งสองฝั่ง และนับลำดับการอ่านด้วย ค่าเฉลี่ยคิดจาก 12 ชุดตัวพิมพ์ ได้แก่ เอกสารงบประมาณของรัฐสภา ราชกิจจานุเบกษา หนังสือเก่า คำพิพากษาศาลปกครอง หน้าเอกสาร ThaiOCRBench และอื่น ๆ เอนจินสี่ตัวในนั้นรันบน CPU
| รันบน CPU | เฉลี่ย 12 ชุดตัวพิมพ์ | ราชกิจจานุเบกษา | เอกสารงบประมาณ (ตรวจแล้ว) | หนังสือเก่า | หน้าเอกสาร ThaiOCRBench | วินาทีต่อหน้า | วินาที CPU ต่อหน้า |
|---|---|---|---|---|---|---|---|
| OpenThai 2.0 OCR Text | 87.8 | 96.3 | 99.5 | 77.1 | 82.0 | 0.39 | 0.50 |
| OneOCR (Microsoft, Windows) | 85.0 | 96.6 | 99.8 | 78.6 | 81.8 | 0.72 | 2.22 |
| PaddleOCR 3, PP-OCRv5 ภาษาไทย | 81.1 | 82.9 | 93.1 | 55.5 | 75.8 | 15.20 | 16.29 |
| Tesseract 5 ภาษาไทยและอังกฤษ | 75.4 | 82.3 | 71.3 | 52.2 | 75.0 | 1.40 | 1.66 |
ในกลุ่มเอนจินที่รันบน CPU โมเดลนี้มีค่าเฉลี่ยสูงสุดและเร็วที่สุด OneOCR ที่มากับ Windows ทำได้ดีกว่าเล็กน้อยบนราชกิจจานุเบกษา เอกสารงบประมาณ และหนังสือเก่า 0.3 ถึง 1.5 คะแนน แต่ใช้เวลา CPU ต่อหน้ามากกว่าสี่เท่า ส่วน Tesseract เอนจินโอเพนซอร์สที่ใช้กันแพร่หลาย ได้ค่าเฉลี่ยต่ำกว่า 12.4 คะแนน
โมเดลที่รันบน GPU ได้ค่าเฉลี่ยสูงกว่า คือ Typhoon OCR V2 2B ได้ 89.6 และ OpenThai 2.0 OCR Markdown ได้ 90.3 และอ่านลายมือ ตาราง และภาพถ่ายได้ดีกว่ามาก บนลายมือได้ 76.7 และ 78.9 ขณะที่โมเดลนี้ได้ 10.3
ความเร็ววัดแบบอ่านทีละหน้าบนหน้าตัวพิมพ์ชุดเดียวกัน 24 หน้า วินาที CPU วัดจากหนึ่งเวิร์กเกอร์แบบเธรดเดียวบนคอร์ Intel Xeon 8468 บน MacBook Pro ชิป M3 Max ด้วย ONNX Runtime หน้าเอกสารภาษาไทย 12 หน้าในชุดตัวอย่างบนหน้า OCR API ใช้เวลามัธยฐาน 0.35 วินาทีต่อหน้า ตารางเต็มของทั้ง 15 เอนจินและรายชื่อ 12 ชุดอยู่ในการ์ดโมเดล
วิธีรัน
pip install onnxruntime opencv-python-headless pyclipper numpy pillow huggingface_hub
hf download iapp/OpenThai2.1-OCR-Text-20261118 --local-dir OpenThai-OCR-Text
cd OpenThai-OCR-Text
from runtime.line_engine import LineOCR

ocr = LineOCR(".", threads=1)
r = ocr.read("page.png")        # a path, bytes, a BGR array or a PIL image
print(r["text"])                # the page's text in reading order
for line in r["lines"]:         # every line with its confidence and its box
    print(line["confidence"], line["box"], line["text"])
คำสั่งดาวน์โหลดจะได้รุ่นล่าสุด ถ้าต้องการรุ่นที่บทความนี้อธิบาย ให้เติม --revision v2.0.0 ในบรรทัด hf download ถ้าต้องอ่านหลายพันหน้า ให้รันหนึ่งโปรเซสต่อหนึ่งคอร์ด้วย threads=1 เพราะการเพิ่มเธรดในโปรเซสเดียวช่วยได้แค่ราวสองคอร์
- ทีละขั้นตอนบน Windows, Mac และ Linux พร้อมสคริปต์สำหรับ PDF: วิธีรัน OpenThai OCR บนคอมพิวเตอร์ของคุณเอง
- ไม่ต้องเขียนโค้ด: Chinda Bot ผู้ช่วยบนเดสก์ท็อปที่ใช้ได้ฟรีของเรา อ่าน PDF ด้วยโมเดลนี้บนเครื่องของคุณเอง
- ใช้เป็นบริการ: OCR Text API ใช้โมเดลนี้ ราคา 0.049 IC ต่อหน้าสำหรับข้อความ และ 0.15 IC ต่อหน้าสำหรับ JSON โครงหน้า หรือไฟล์ Word, PowerPoint, Excel และ PDF ที่ค้นหาข้อความได้
ข้อจำกัด
- อ่านตัวพิมพ์เท่านั้น ลายมือและข้อความในภาพถ่ายฉากทั่วไปอ่านได้ไม่ดี ส่วนที่เขียนด้วยมือบนหน้าตัวพิมพ์จะถูกข้ามไป เช่น วันที่ที่เขียนด้วยมือบนหนังสือในภาพด้านบน
- ฟอนต์ตกแต่ง: ข้อความสั้น ๆ ในฟอนต์ที่ตกแต่งมาก อาจอ่านผิด
- ตราประทับออกมาเป็นข้อความ เพราะเป็นข้อความบนหน้าเอกสาร
- ความเร็ว 0.39 วินาทีต้องใช้ AMX (Intel Sapphire Rapids ขึ้นไป) ซึ่งรันแบบ bfloat16 ส่วน CPU อื่นรันแบบ float32 และช้ากว่า
- คำพิพากษาอยู่ในโดเมนที่เทรน: ข้อมูลเทรนมีภาพสแกนของศาลปกครอง แต่ไม่ใช่ 150 ฉบับที่ใช้ทดสอบ คะแนนคำพิพากษา (97.0 สูงสุดใน 15 เอนจิน) จึงไม่ใช่การทดสอบกับเอกสารประเภทที่ไม่เคยเห็น
สร้างอย่างไร
โมเดลมีสองส่วน คือตัวหาบรรทัดข้อความ (1.8 MB) และตัวอ่านบรรทัดภาษาไทย (2.4 MB) ตัวอ่านบรรทัดได้ชั้นเอาต์พุตภาษาไทยใหม่ และถูกเทรนต่อบนบรรทัดข้อความจริง 410,270 บรรทัด
- 261,877 บรรทัดจากภาพสแกนของศาลปกครอง ใช้ข้อความต้นฉบับของศาลเป็นเฉลย
- 41,101 บรรทัดจาก PDF เอกสารงบประมาณของรัฐสภา เก็บเฉพาะบรรทัดที่ชั้นข้อความใน PDF ตรงกับที่ตัวอ่านบรรทัดอ่านได้
- 107,292 บรรทัดจากหนังสือเก่าในวิกิซอร์ซ
และบรรทัดภาษาไทยและอังกฤษสังเคราะห์ที่สร้างจากฟอนต์สัญญาอนุญาตเปิด 85 ฟอนต์ ไม่ได้ใช้ชุดข้อมูลส่วนบุคคล และกันเอกสารที่ใช้ทดสอบทุกฉบับออกจากข้อมูลเทรน น้ำหนักของตัวอ่านบรรทัดอยู่ในรีโพสิทอรีสำหรับเทรนต่อ
สัญญาอนุญาต
Apache-2.0 ใช้เชิงพาณิชย์ได้ ตัวหาบรรทัดคือ PP-OCRv6-tiny ของ PaddlePaddle ตามที่เผยแพร่ และตัวอ่านบรรทัดเทรนต่อจากตัวอ่านของ PP-OCRv6-tiny ทั้งสองใช้สัญญาอนุญาต Apache-2.0 และมีประกาศอยู่ในรีโพสิทอรี
พัฒนาโดย iApp เปิดตัวร่วมกับ AIEAT เทรนบน GPU NVIDIA H100 ที่สนับสนุนโดย Siam AI Corporation
ถ้ามีเอกสารภาษาไทยที่อ่านได้ไม่ดี ส่งตัวอย่างที่ไม่มีข้อมูลส่วนบุคคลมาที่ sale@iapp.co.th หน้าเหล่านั้นช่วยให้เราปรับปรุงรุ่นถัดไป