OpenThai 2.0 OCR Text:可在任意 CPU 上运行的免费泰文 OCR 模型

OpenThai 2.1 OCR Text 已经发布。它沿用本文介绍的模型文件,并新增运行时和第二个识别器:保留古籍的声调符号,能读 Kanit、Prompt 等无圈字体,并保留只有一个字符的表格单元格。本文介绍的是 2.0 版,它仍可通过标签 v2.0.0 获取;下文的下载链接现在指向 2.1 版。
今天我们发布 OpenThai 2.0 OCR Text,这是来自 OpenThai(原 OpenThaiGPT)的模型,可从扫描件和页面图像中读取泰文与英文印刷文字。它体积很小:102 万参数,两个文件合计 4.2 MB。在普通 CPU 上读取一页文字密集的 A4 只需 0.39 秒,无需 GPU,也无需联网,因此文件不必离开读取它的电脑。它以 Apache-2.0 许可在 Hugging Face 免费下载,也是 iApp OCR Text API 背后的引擎。
模型页面:iapp.co.th/openmodels/openthai2p0-ocr-text · 权重:huggingface.co/iapp/OpenThai2.1-OCR-Text-20261118
功能
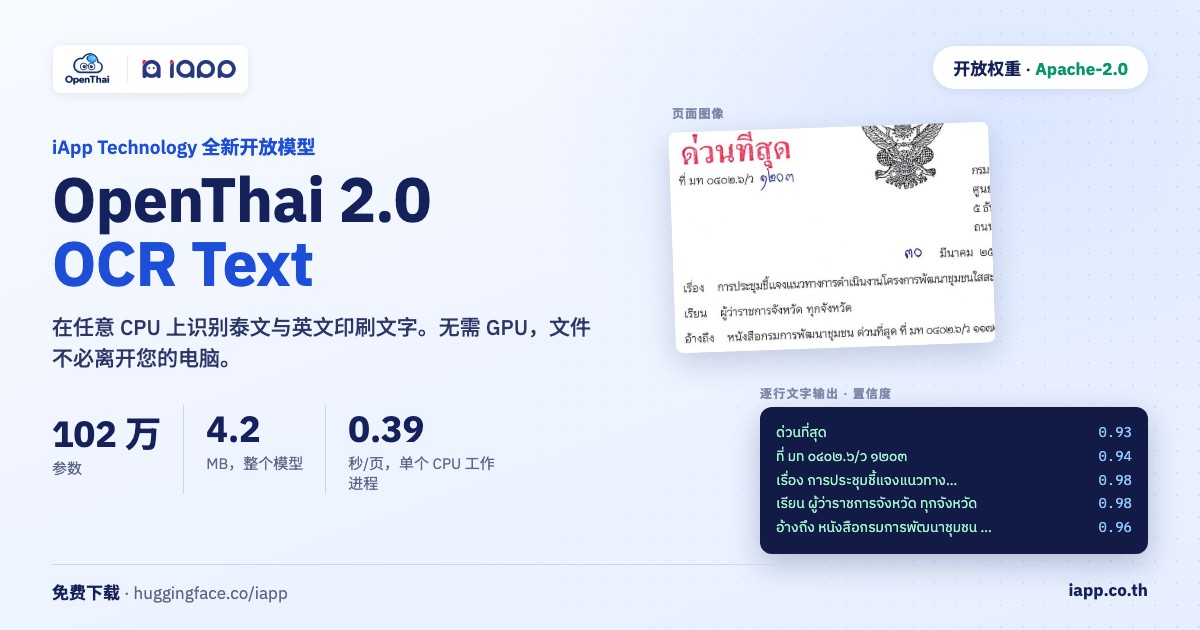
输入一张页面图像,它按阅读顺序返回页面文字。每一行还附带边框(坐标与您输入的图像一致)和 0 到 1 之间的置信度,因此可以把把握不大的行交给人工核对。
读取之前,它会按真实扫描件的需要先处理页面:
- **方向:**侧放或倒置的页面会转到文字行读得最好的方向。
- **倾斜:**倾斜超过 2.5 度的扫描件会被校正,边框按原始图像的坐标返回。
- **阅读顺序:**两栏和三栏页面逐栏读取;表格、预算页面和列表保持行序。
- **颜色:**逐栏减去背景色,因此深色背景上的浅色文字、彩色幻灯片和渐变背景都能读取。
它通过了稳健性测试的全部 22 种条件(旋转、倾斜、极大和极小的文字、颜色、褪色印刷、复印噪点、手机照片、表格和分栏),每种条件 20 页未参与训练的页面,通过标准在首次运行前就已确定。
它输出文字,不输出表格。需要让表格保持为表格的整页文档,请使用同日发布的 OpenThai 2.0 OCR Markdown。
为什么要小模型
许多机构不能把文件交给外部服务处理,例如政府部门、医院、银行和律师事务所。在保存文件的那台电脑的 CPU 上运行的模型,可以就地读取这些文件。读取进程每页消耗 0.5 CPU 秒、约 450 MB 内存,因此一台 8 核服务器每分钟约可读 950 页:一百万页不到一天即可读完,无需 GPU。
测评结果
模型卡在相同的页面上测试了 15 个 OCR 引擎,并以相同方式评分:字符准确率,即 100 ×(1 − 字符错误率),越高越好;评分前去除两侧的标记,并计入阅读顺序。平均值覆盖 12 个印刷文字测试集,包括泰国国会预算文件、皇家公报、古籍、行政法院判决书、ThaiOCRBench 页面等。其中 4 个引擎在 CPU 上运行:
| 在 CPU 上运行 | 12 个印刷文字测试集平均 | 皇家公报 | 预算文件(已核对) | 古籍 | ThaiOCRBench 页面 | 每页秒数 | 每页 CPU 秒数 |
|---|---|---|---|---|---|---|---|
| OpenThai 2.0 OCR Text | 87.8 | 96.3 | 99.5 | 77.1 | 82.0 | 0.39 | 0.50 |
| OneOCR(Microsoft,Windows) | 85.0 | 96.6 | 99.8 | 78.6 | 81.8 | 0.72 | 2.22 |
| PaddleOCR 3,PP-OCRv5 泰文 | 81.1 | 82.9 | 93.1 | 55.5 | 75.8 | 15.20 | 16.29 |
| Tesseract 5,泰文与英文 | 75.4 | 82.3 | 71.3 | 52.2 | 75.0 | 1.40 | 1.66 |
在 CPU 引擎中,它的平均分最高,速度也最快。Windows 自带的 OneOCR 在皇家公报、预算文件和古籍上略胜 0.3 到 1.5 分,但每页所需的 CPU 时间是它的四倍多。广泛使用的开源引擎 Tesseract 平均分低 12.4 分。
在 GPU 上运行的模型平均分更高:Typhoon OCR V2 2B 为 89.6,OpenThai 2.0 OCR Markdown 为 90.3。它们在手写、表格和照片上也读得好得多:手写得分分别为 76.7 和 78.9,而本模型为 10.3。
速度为逐页处理,使用同样的 24 页印刷页面;CPU 秒数为 Intel Xeon 8468 单核上的单线程工作进程。在搭载 M3 Max 的 MacBook Pro 上使用 ONNX Runtime,OCR API 页面示例集中的 12 页泰文文档每页用时中位数为 0.35 秒。15 个引擎的完整表格和 12 个测试集的列表见模型卡。
运行
pip install onnxruntime opencv-python-headless pyclipper numpy pillow huggingface_hub
hf download iapp/OpenThai2.1-OCR-Text-20261118 --local-dir OpenThai-OCR-Text
cd OpenThai-OCR-Text
from runtime.line_engine import LineOCR

ocr = LineOCR(".", threads=1)
r = ocr.read("page.png")        # a path, bytes, a BGR array or a PIL image
print(r["text"])                # the page's text in reading order
for line in r["lines"]:         # every line with its confidence and its box
    print(line["confidence"], line["box"], line["text"])
下载得到的是最新版本;如需本文介绍的版本,请在 hf download 一行加上 --revision v2.0.0。处理成千上万页时,每个 CPU 核心运行一个进程并设 threads=1;同一进程内的线程超过约两个核心后就不再有帮助。
- Windows、Mac 和 Linux 的分步教程,附 PDF 脚本:如何在自己的电脑上运行 OpenThai OCR。
- **无需编写代码:**我们的免费桌面助手 Chinda Bot 在您自己的电脑上用本模型读取 PDF。
- 托管服务:OCR Text API 运行本模型,文字输出每页 0.049 IC,版面 JSON 或 Word、PowerPoint、Excel、可搜索 PDF 文件每页 0.15 IC。
局限
- **仅限印刷文字。**手写和场景文字读得不好。印刷页面上的手写部分会被略过,例如上图公函上手写的日期。
- **装饰性展示字体:**高度风格化字体中的短标签可能被误读。
- 印章会被读成文字,因为它们就是页面上的文字。
- 0.39 秒的速度需要 AMX(Intel Sapphire Rapids 或更新),此时以 bfloat16 运行;其他 CPU 以 float32 运行,速度较慢。
- **判决书属于训练领域:**训练数据包含行政法院的扫描件(不包括测试用的 150 份文书),因此其判决书得分(97.0,15 个引擎中最高)并不是对未见过类型文档的测试。
构建方式
模型由两部分组成:文本行检测器(1.8 MB)和泰文行识别器(2.4 MB)。识别器换上了新的泰文输出层,并在 410,270 行真实文本上微调:
- 261,877 行来自行政法院扫描件,以法院自己的文本为标注;
- 41,101 行来自泰国国会预算 PDF,仅保留 PDF 文本层与识别器结果一致的行;
- 107,292 行来自维基文库古籍;
另有用 85 种开放许可字体渲染的泰文与英文合成文本行。未使用任何个人数据集,所有测试文档均排除在训练之外。识别器权重已放在仓库中,可用于进一步训练。
许可
Apache-2.0,可用于商业用途。检测器为 PaddlePaddle 发布的 PP-OCRv6-tiny 原版,识别器由 PP-OCRv6-tiny 的识别器微调而来;两者均为 Apache-2.0 许可,相关声明见仓库。
由 iApp 开发,与 AIEAT 联合发布。在 Siam AI Corporation 提供的 NVIDIA H100 GPU 上训练。
如果某份泰文文档读得不好,请把不含个人数据的样本发送至 sale@iapp.co.th;这些页面能帮助我们改进下一个版本。