OpenThai 2.0 OCR Markdown:把泰文文档连同表格读成 Markdown 的开放模型

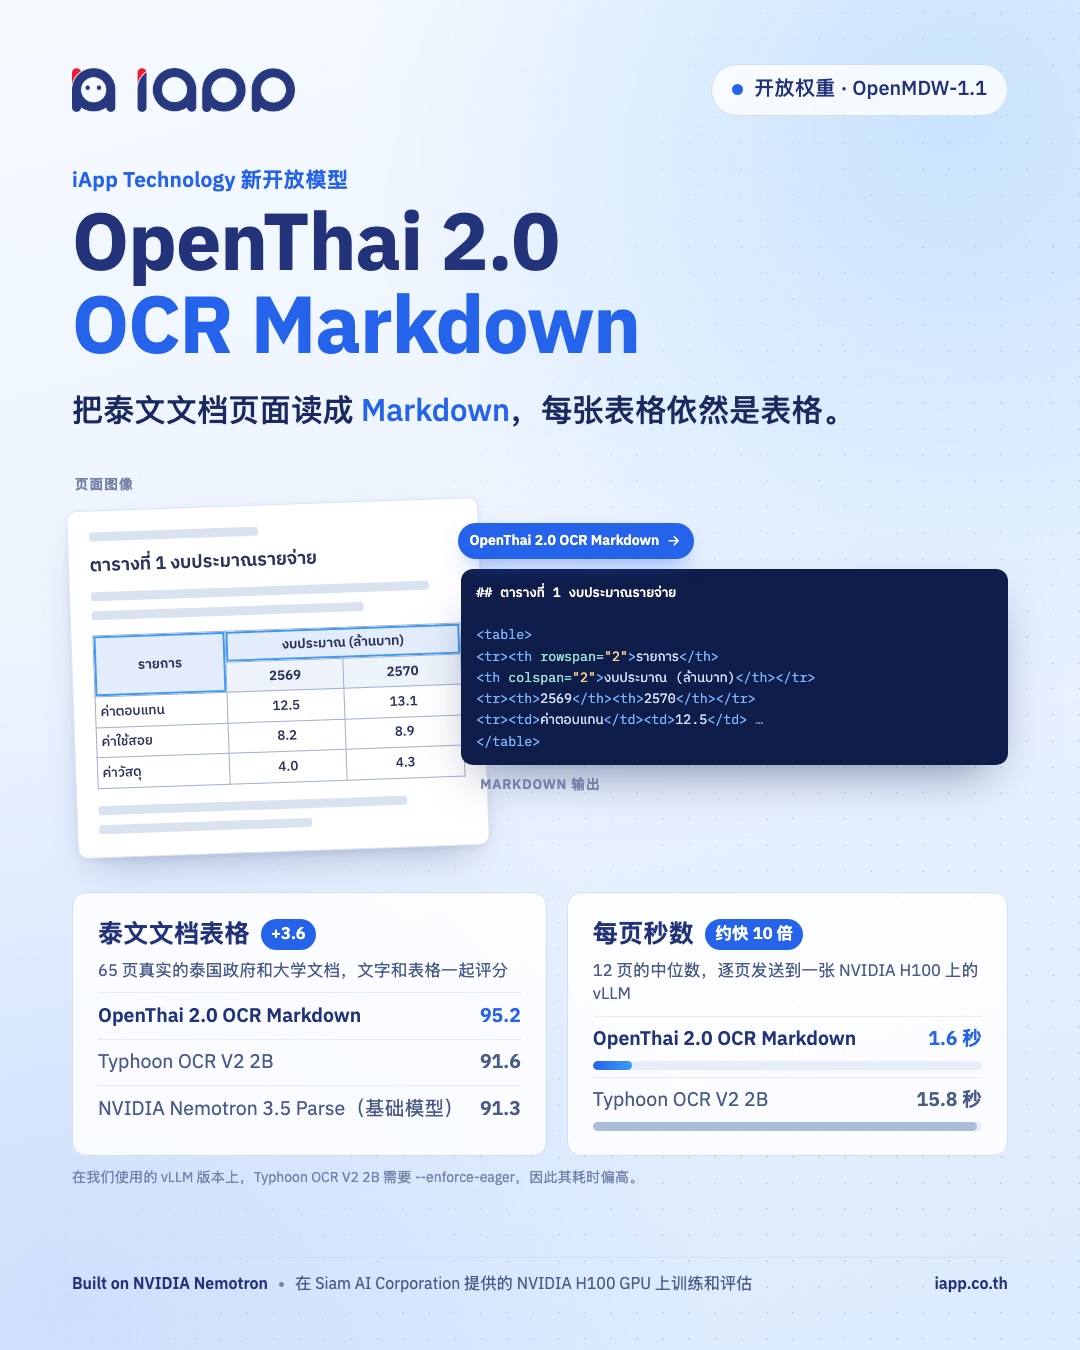
今天我们发布 OpenThai 2.0 OCR Markdown,一个开放权重模型,将泰文和英文文档页面读成 Markdown,每张表格都以 HTML 输出。它有 0.63B 参数,在一张 NVIDIA H100 上每页 1.6 秒,可在 Hugging Face 上按 OpenMDW-1.1 许可免费下载。同一模型也以 API 形式提供,每页 0.15 IC。
模型页面:iapp.co.th/openmodels/openthai2p0-ocr-markdown · 权重:huggingface.co/iapp/OpenThai2.0-OCR-Markdown
为什么是表格
泰国政府机构和大学的文档里满是表格:预算明细、日程表,以及表头跨越多行多列的表单。只返回文字行的 OCR 会丢失每个数字属于哪一行哪一列。OpenThai 2.0 OCR Markdown 将每张表格写成带 rowspan 和 colspan 的 HTML,这些结构便能完整地进入你的搜索索引或语言模型。表格之外的标题、列表和段落以 Markdown 输出,每个区块都带有位置框和类别,并按阅读顺序排列。
测评结果
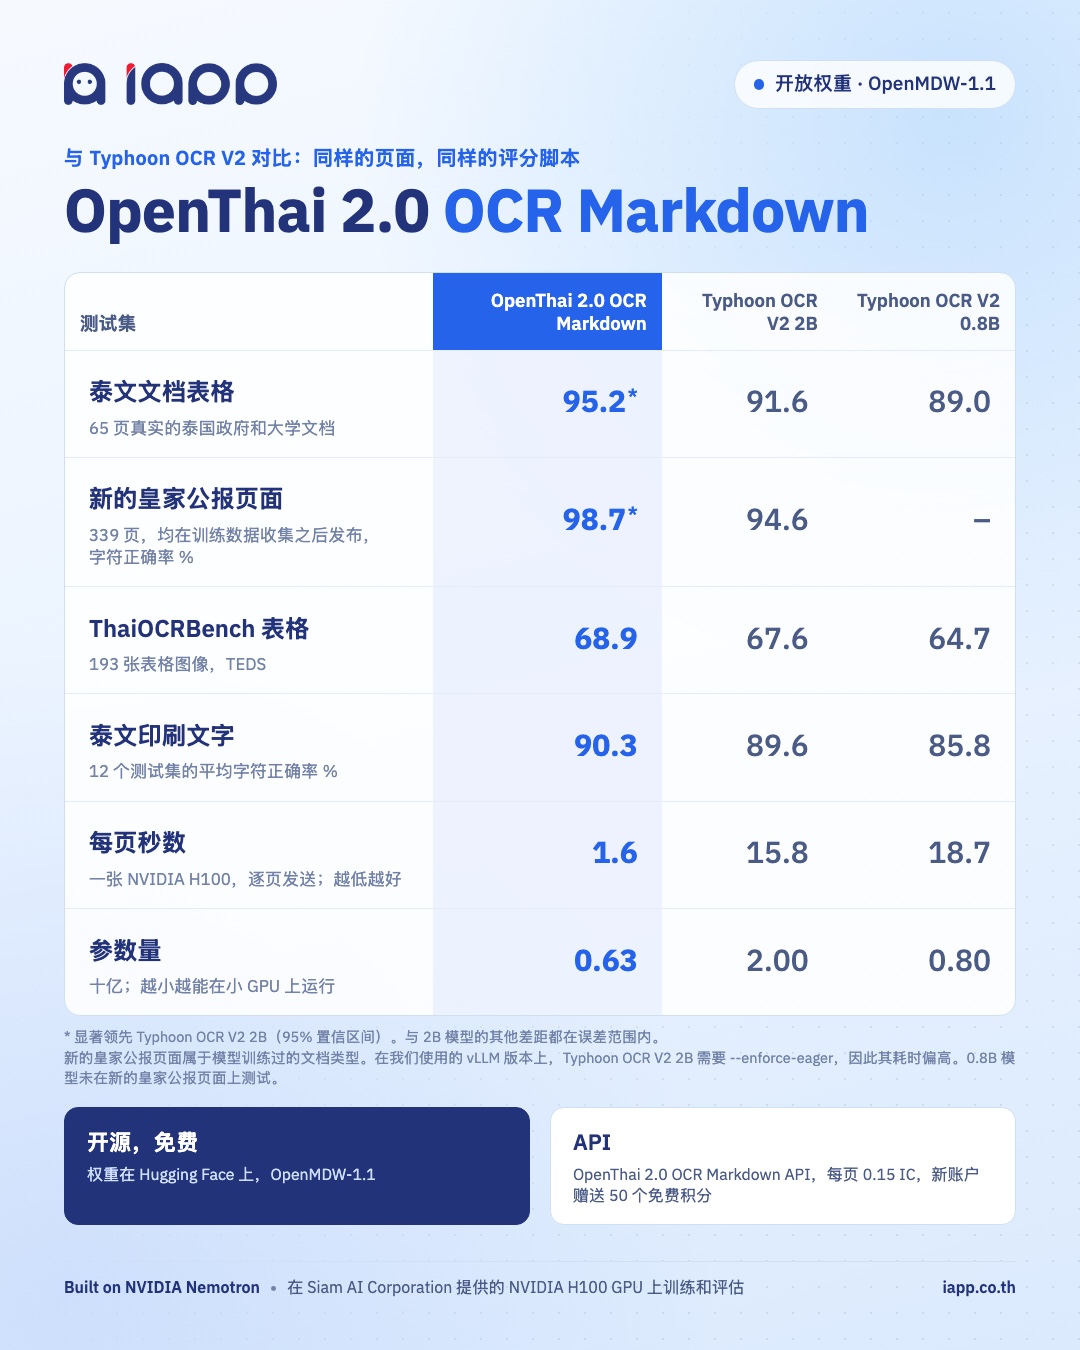
所有模型读取相同的页面,并由同一脚本评分;Typhoon OCR V2 2B 与 Typhoon OCR V2 0.8B 使用其模型卡上的设置。区间为按页配对 bootstrap 的 95% 区间。
| 模型 | 规模 | 泰文文档表格 | ThaiOCRBench 表格 | 泰文印刷文字 | 每页秒数 | 新皇家公报页面 |
|---|---|---|---|---|---|---|
| OpenThai 2.0 OCR Markdown | 0.63B | 95.2 | 68.9 | 90.3 | 1.6 | 98.7 |
| Nemotron 3.5 Parse(基础模型) | 0.63B | 91.3 | 68.3 | 89.0 | 1.8 | 91.5 |
| Typhoon OCR V2 2B | 2B | 91.6 | 67.6 | 89.6 | 15.8 | 94.6 |
| Typhoon OCR V2 0.8B | 0.8B | 89.0 | 64.7 | 85.8 | 18.7 | – |
- 泰文文档表格:65 页泰国政府机构和大学的真实文档,文字与表格合并评分。比 Typhoon OCR V2 2B 高 3.6 分,95% 区间 [+1.2, +6.2];比其基础模型高 3.9 分。
- ThaiOCRBench 表格:在其 193 张表格图像上评估表格结构与内容(TEDS)。对 Typhoon OCR V2 2B 为 +1.3,[−1.7, +4.6]:持平。
- 泰文印刷文字:字符准确率 100 × (1 − 字符错误率),为 12 个测试集的平均,共 1,200 页及 50 份完整的行政法院判决书。对 Typhoon OCR V2 2B 为 +0.76,[−0.04, +1.51]:持平。因重复循环被截断的页面按空白计;2,270 页中没有一页被截断。
- 每页秒数:在一张 NVIDIA H100 上通过 vLLM 逐页发送 12 页的中位数。Typhoon OCR V2 2B 在我们使用的 vLLM 版本上需要
--enforce-eager,因此其时间偏慢。 - 新皇家公报页面:339 页,来自 2026 年 11 月 4–9 日 发布的 293 份文件,晚于我们收集训练数据的时间。该测试集在任何模型读取之前锁定,每个模型对每页只读一次;指标为字符准确率。这些是新文件,但属于 OpenThai 2.0 OCR Markdown 训练过的类型(此前月份的皇家公报页面),因此它们说明的是模型读取未见过的文件的能力,而不是读取新类型文件的能力。参考文本由制作我们皇家公报训练标签的同一工具生成,因此遵循本模型学过的书写惯例。对 Typhoon OCR V2 2B 为 +4.1,[+3.7, +4.4];去掉所有空格、使换行合并方式不计入时,为 +3.5,[+3.2, +3.9]。Typhoon OCR V2 0.8B 未在此测试集上运行。
在泰文文档表格上,它显著优于 Typhoon OCR V2 2B;在 ThaiOCRBench 表格和印刷文字上两者持平。它的速度约快 10 倍,规模约为其三分之一。在我们收集训练数据之后发布的 339 页新皇家公报上,其字符准确率为 98.7%,Typhoon OCR V2 2B 为 94.6%,同样显著领先;这些是新文件,但属于它训练过的类型。12 个印刷文字测试集的逐项结果见模型页面。
我们如何构建它
我们从 NVIDIA Nemotron 3.5 Parse 出发,这个 0.63B 模型本身已能读取版面、区块类别和阅读顺序,我们针对泰文进行了微调。其部署与后处理工具保持不变,因此凡能运行基础模型的环境都能运行 OpenThai 2.0 OCR Markdown。
文字标签完全准确,从不使用其他模型的识别结果。训练数据共 54,596 行:
- 合成泰文文档:在浏览器中以泰文维基百科文字和 24 种开放许可字体渲染,包括表单、备忘录、会议纪要、日程表和合并单元格表格,并加入扫描与手机拍摄的退化效果。两栏和三栏页面让模型学会逐栏阅读。
- 原生数字的泰国政府页面:泰国国会预算文件和皇家公报,其 PDF 文字层提供准确文字,表格线提供准确的表格结构。
- 其他类型的表格:公开数据集 FinTabNet 和 PubTabNet 中的金融与科研表格,以及合成的泰文收据、对账单、化验与保险报告和多级行表头表格,其中一部分的数字全部为泰文数字。
- 短裁剪图:手写文字行、英文文字和生成的针式打印文字,使模型保持读取短文本的能力。
- 曾陷入循环的页面:420 页,来自旧书扫描、合成收据照片和政府页面,此前的微调版本在这些页面上陷入重复循环。每页使用该版本自己的输出直到循环开始处,训练降低模型再次写出该循环的概率。
我们在一张 H100 上训练一个轮次,共 1,707 步。发布的是最后一个检查点,按训练结果原样使用,未混入基础模型的权重。
该检查点由在评分任何候选之前写定的规则选出,只使用开发集;上文的测试结果均未用于选择。模型卡列出了这一规则。训练未使用任何测试集页面。
局限
- 在我们的测试中没有页面陷入重复循环:2,270 页印刷文字、193 张 ThaiOCRBench 表格图像和 6,137 页开发集页面。若某页陷入循环,解析器会报错,以便交给其他识别器。
- 拍摄的单个词语和很短的裁剪图识别效果不如整页:96.4,Typhoon OCR V2 2B 为 99.8。
- 针式打印文字(如银行存折和针式打印的表单)识别效果不如普通印刷文字:在我们的开发集裁剪图上,字符准确率约 89%;这些裁剪图是生成的,目前还没有真实针式打印的测试集,因此真实存折上的结果预计会更低。
- 整页手写、场景文字和屏幕照片不是目标。
获取
权重、模型卡和 NVIDIA 的 nemotron_parse 软件包都在 Hugging Face 上,可免费下载;模型页面给出了用 vLLM 部署和解析一页的命令。如果不想自己维护 GPU,OpenThai 2.0 OCR Markdown API 在泰国境内运行同一模型,每页 0.15 IC。
OpenThai 2.0 OCR Markdown 是 NVIDIA Nemotron 3.5 Parse 的衍生模型,依据 OpenMDW License Agreement 1.1 版发布。Built on NVIDIA Nemotron. 在 Siam AI Corporation 提供的 NVIDIA H100 GPU 上训练和评估。