在 OpenWebUI 中运行 ChindaLLM 4B
完成以下步骤后,ChindaLLM 4B 会在浏览器聊天界面中用泰语回答,全部运行在您自己的机器上。
准备: Docker(Windows 或 macOS 请用 Docker Desktop)、可容纳 OpenWebUI 镜像和 2.5 GB 模型的磁盘空间、至少 4 GB 内存(建议 8 GB)。NVIDIA GPU 可选。
1. 启动 OpenWebUI
一个容器即可运行 OpenWebUI 及其内置的 Ollama。
- CPU
- NVIDIA GPU
- Docker Compose
docker run -d -p 3000:8080 -v ollama:/root/.ollama -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:ollama
请先安装 NVIDIA Container Toolkit。
docker run -d -p 3000:8080 --gpus all -v ollama:/root/.ollama -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:ollama
保存为 docker-compose.yml,使用 GPU 时取消 deploy 部分的注释,然后运行 docker-compose up -d。
version: '3.8'

services:
  open-webui:
    image: ghcr.io/open-webui/open-webui:ollama
    container_name: open-webui
    ports:
      - "3000:8080"
    volumes:
      - ollama:/root/.ollama
      - open-webui:/app/backend/data
    restart: always
    # 取消注释下面的行以支持 GPU
    # deploy:
    #   resources:
    #     reservations:
    #       devices:
    #         - driver: nvidia
    #           count: all
    #           capabilities: [gpu]

volumes:
  ollama:
  open-webui:
2. 创建管理员账户
打开 http://localhost:3000 并注册;账户只保存在您的机器上,不会向外发送任何数据。
3. 下载模型
在模型搜索框中输入 iapp/chinda-qwen3-4b,点击 Pull "iapp/chinda-qwen3-4b" from Ollama.com。
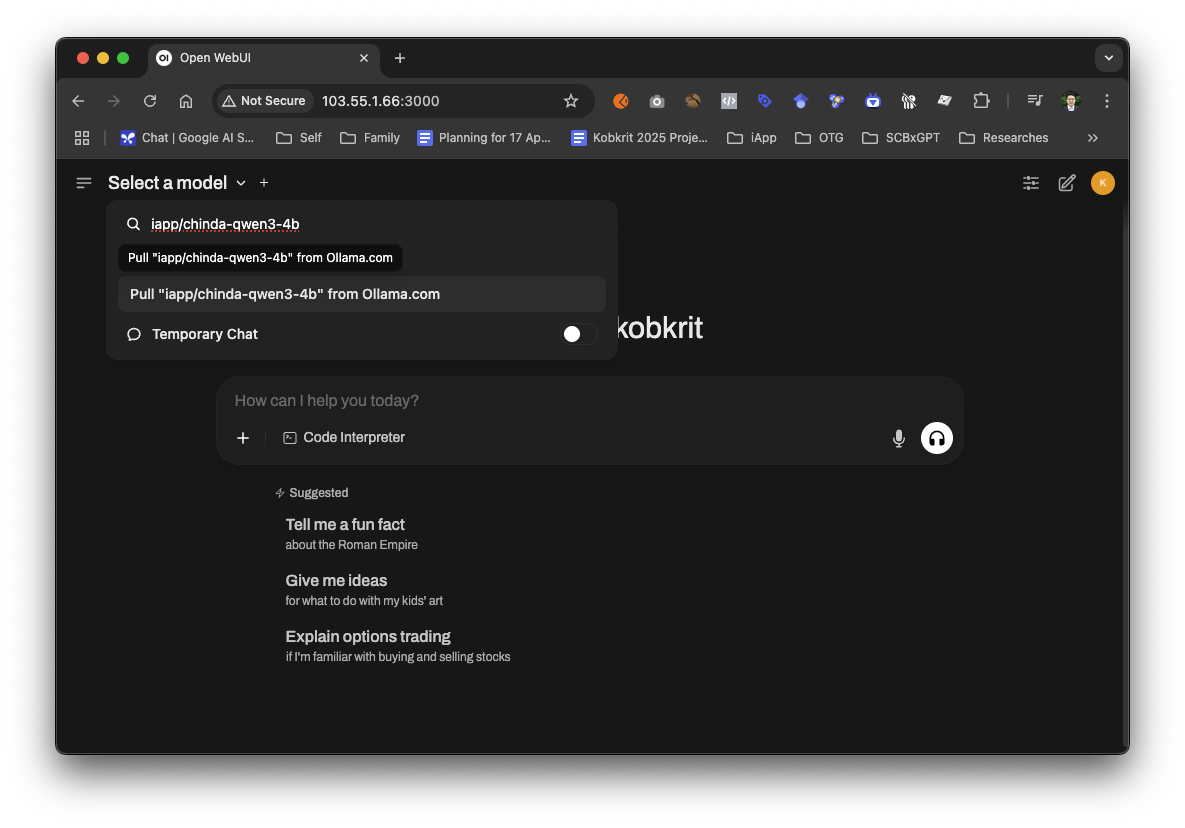
也可以在终端中执行:
docker exec -it open-webui ollama pull iapp/chinda-qwen3-4b
4. 用泰语聊天
在模型菜单中选择 iapp/chinda-qwen3-4b:latest,然后用泰语输入。
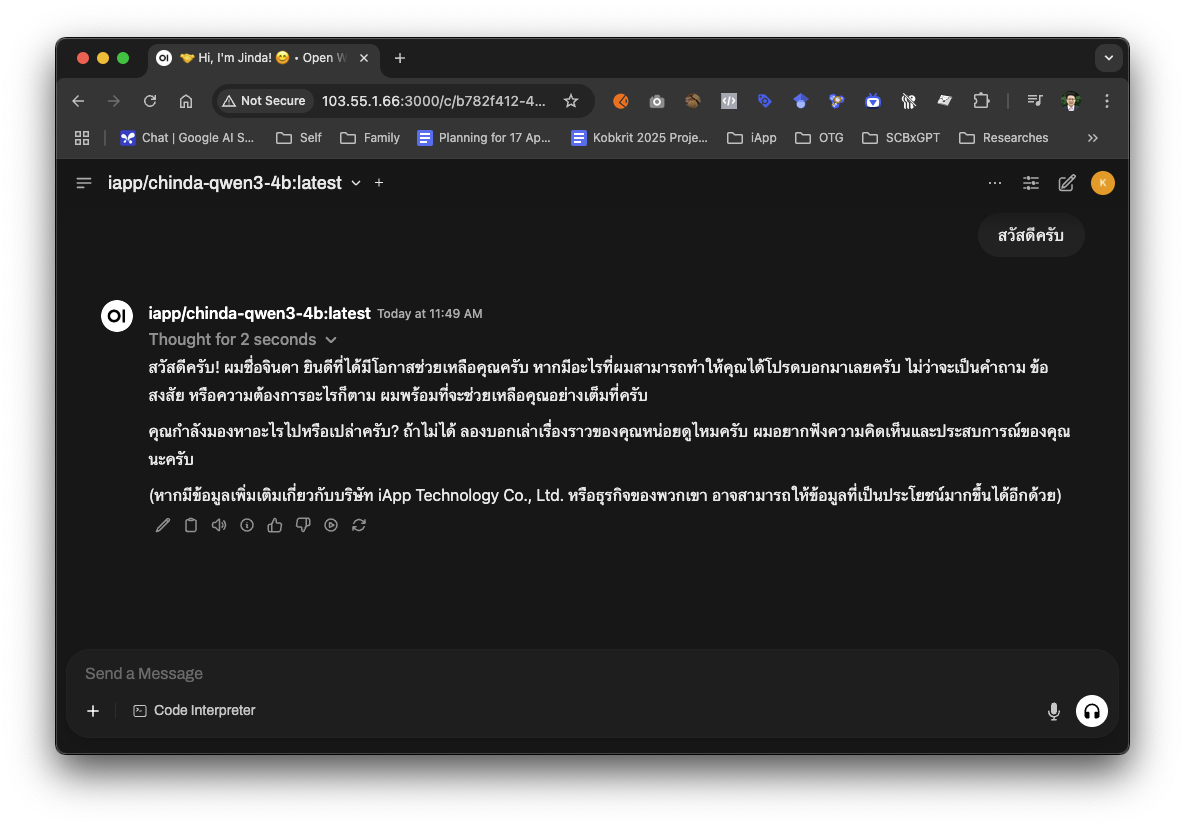
涉及事实时,请把原文粘贴到对话中:在没有上下文的情况下询问最新新闻、统计数据或具体人物,40 亿参数的模型可能会编造答案。
5. 调整参数(可选)
在模型设置中,Temperature 0.7、Top P 0.9、Top K 40 适合 Chinda;系统提示词可设定它的角色,例如:
คุณเป็นผู้ช่วยเขียนเอกสารมืออาชีพ ตอบด้วยภาษาไทยที่เป็นทางการและสุภาพ
故障排除
- 模型菜单中没有 Chinda。 用
docker exec -it open-webui ollama list确认已下载,缺失则重新拉取,然后刷新页面。 - 页面无法打开。 用
docker ps -a和docker logs open-webui检查容器,然后执行docker restart open-webui。 - 回答缓慢。 有 GPU 时先检查
nvidia-smi;如果容器启动时没有加--gpus all,执行docker stop open-webui和docker rm open-webui,再运行 NVIDIA GPU 选项卡中的命令。没有 GPU 时,关闭其他程序并调低 Max Tokens。
更新、备份与管理模型
# 更新 OpenWebUI,然后重新运行第 1 步的命令
docker pull ghcr.io/open-webui/open-webui:ollama
docker stop open-webui
docker rm open-webui

# 将两个卷备份到当前目录
docker run --rm -v ollama:/source -v $(pwd):/backup alpine tar czf /backup/ollama-backup.tar.gz -C /source .
docker run --rm -v open-webui:/source -v $(pwd):/backup alpine tar czf /backup/openwebui-backup.tar.gz -C /source .

# 拉取或删除其他模型
docker exec -it open-webui ollama pull <model-name>
docker exec -it open-webui ollama rm <model-name>
该模型采用 Apache 2.0 许可证,可用于商业用途:模型主页、Hugging Face、Ollama、OpenWebUI 的 GitHub。如想免安装试用,请在 chindax.iapp.co.th 选择 ChindaLLM 4B。