ChindaMT: การแปลภาษาไทย-อังกฤษที่ทำตามกฎของคุณ ตีพิมพ์ที่ AACL-IJCNLP 2026

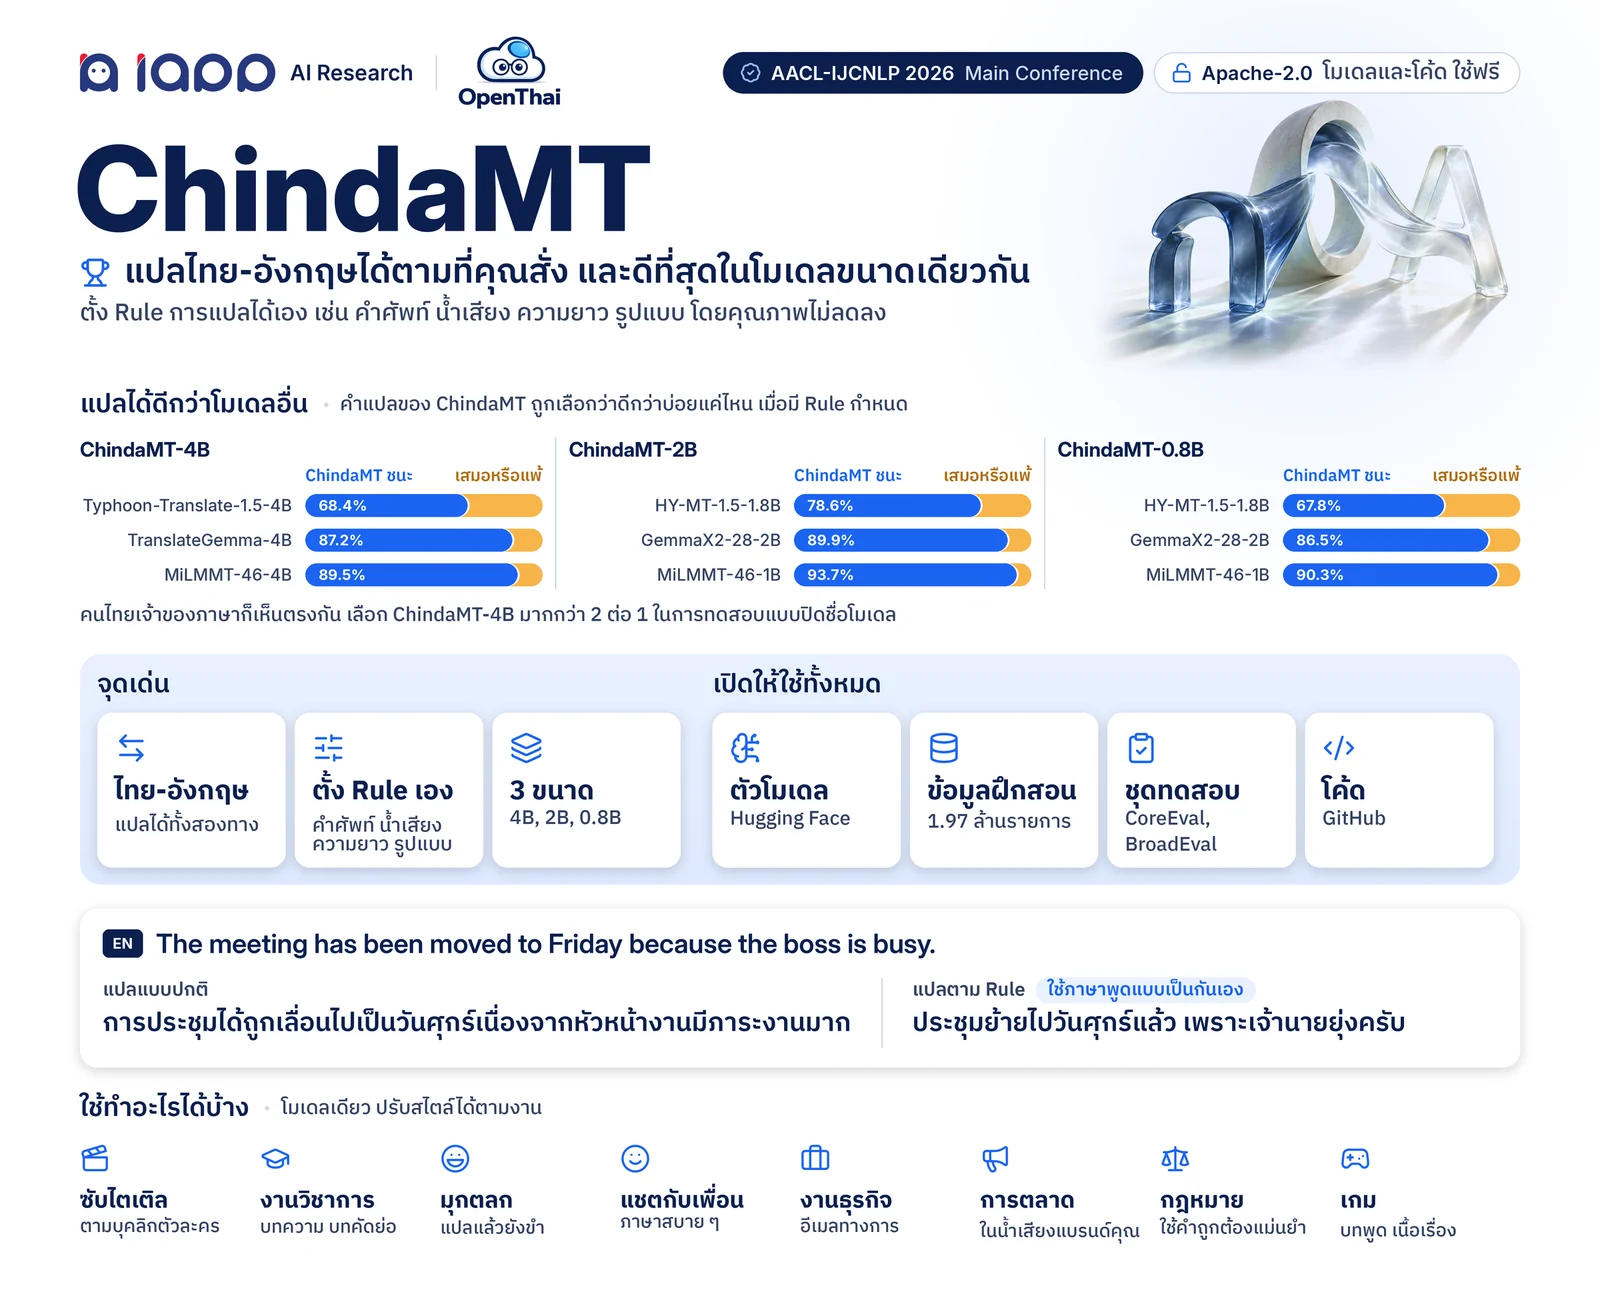
วันนี้เราเปิดตัว ChindaMT กลุ่มโมเดลแปลภาษาไทย-อังกฤษที่ทำตามกฎที่คุณกำหนด ได้แก่ คำศัพท์ที่ต้องใช้ น้ำเสียงที่ต้องการ ความยาว และรูปแบบ งานวิจัยเบื้องหลังตีพิมพ์ที่ AACL-IJCNLP 2026 (Main Conference) โมเดล ข้อมูลเทรน ชุดประเมินผล และโค้ด เปิดภายใต้ Apache 2.0 และ ChindaMT-4B พร้อมให้ใช้งานเป็น API แบบโฮสต์แล้ววันนี้
ลองใช้: ChindaMT แปลภาษาไทย-อังกฤษ · API: เอกสารและหน้าทดลองใช้งาน · บทความวิจัย: arxiv.org/abs/2609.34770 · น้ำหนักโมเดล: huggingface.co/iapp/ChindaMT-4B
คำแปลที่ถูกต้อง อาจยังไม่เหมาะกับงาน
ลองดูประโยคนี้: "The meeting has been moved to Friday because the boss is busy."
การแปลแบบมาตรฐานได้ การประชุมถูกเลื่อนไปเป็นวันศุกร์เนื่องจากเจ้านายยุ่ง ถูกต้องทุกคำ แต่คงไม่มีใครพิมพ์แบบนี้ลงในแชตกลุ่ม เมื่อกำหนดกฎ "use a casual, friendly tone" ให้ ChindaMT จะได้ ประชุมย้ายไปวันศุกร์แล้วนะ เพราะเจ้านายยุ่งมาก
การแปลแทบไม่เคยมีคำตอบเดียว ซับไตเติลต้องใช้น้ำเสียงของตัวละคร บทความวิชาการต้องใช้ภาษาทางการ แบรนด์ต้องมีสไตล์ของตัวเอง และสัญญาต้องใช้คำเดิมทุกครั้ง ความยากอยู่ที่ว่า ยิ่งผลักดันให้โมเดลทำตามกฎเหล่านี้มากเท่าใด คุณภาพการแปลก็มักยิ่งลดลง โมเดลที่เชี่ยวชาญด้านการแปลแปลได้ดีแต่ไม่ทำตามคำสั่ง ส่วนโมเดลทั่วไปที่ทำตามคำสั่งได้ก็แปลได้ไม่ดีเท่า ที่ผ่านมายังไม่มีโมเดลไทย-อังกฤษแบบเปิดตัวใดปิดช่องว่างนี้ได้
คำตอบอยู่ที่ข้อมูล
เราสร้างข้อมูลเทรนด้วยวิธีที่เรียกว่า Reference-Grounded Data Curation (RGDC) แทนที่จะให้โมเดลภาษาคิดกฎขึ้นมาเองแล้วหวังว่ากฎนั้นจะทำตามได้ RGDC ดึงกฎทุกข้อออกมาจากคำแปลอ้างอิงที่ดีซึ่งทำตามกฎนั้นอยู่แล้ว หากคำแปลอ้างอิงใช้ "THB" แทนคำว่า บาท ใช้เพียงประโยคเดียว และใช้ภาษาทางการ สิ่งเหล่านี้จะกลายเป็นกฎของตัวอย่างนั้น และเป็นกฎที่ทำตามได้แน่นอนโดยวิธีสร้าง เพราะมีคำแปลจริงที่ทำตามได้อยู่แล้ว
ไปป์ไลน์เริ่มจากคู่ประโยคอังกฤษ-ไทย 17.85 ล้านคู่ จากคลังข้อมูลสาธารณะ 10 ชุด ขั้นแรกคัดเก็บ 1.75 ล้านคู่ที่ยากที่สุดแต่ยังเรียนรู้ได้ ขั้นที่สองดึงกฎจากคำแปลอ้างอิงแต่ละรายการใน 5 หมวด (เนื้อหา ตัวเลข สไตล์ รูปแบบ ภาษา) สร้างคำแปลใหม่ภายใต้กฎเหล่านั้น และเก็บเฉพาะคำแปลที่ผ่านกฎทุกข้อ ผลลัพธ์คือ Grounded ชุดข้อมูล 1.97 ล้านรายการ เฉลี่ยรายการละ 3.7 กฎ
ผลลัพธ์
เราปรับแต่ง (fine-tune) โมเดล 3 ขนาด คือ 4B, 2B และ 0.8B แล้วเปรียบเทียบแต่ละขนาดกับโมเดลแปลภาษาแบบเปิดที่มีขนาดเท่ากัน ทั้งสองทิศทาง ทั้งแบบมีและไม่มีกฎ ตัวเลขด้านล่างคือสัดส่วนที่โมเดลผู้ตัดสิน (judge model) เลือกคำแปลของ ChindaMT เมื่อมีการกำหนดกฎ (50% หมายถึงเสมอกัน):
| ChindaMT | เทียบกับ | ได้รับเลือก |
|---|---|---|
| 4B | Typhoon-Translate-1.5-4B | 68.4% |
| 4B | TranslateGemma-4B | 87.2% |
| 4B | MiLMMT-46-4B | 89.5% |
| 2B | HY-MT-1.5-1.8B | 78.6% |
| 2B | GemmaX2-28-2B | 89.9% |
| 0.8B | HY-MT-1.5-1.8B | 67.8% |
| 0.8B | GemmaX2-28-2B | 86.5% |
การทำตามกฎไม่ได้แลกมาด้วยคุณภาพการแปล บน benchmark สาธารณะ FLORES-200 ChindaMT-4B ได้คะแนน 90.7 จากค่าเฉลี่ยของตัวชี้วัดคุณภาพ 3 ตัว สูงที่สุดในกลุ่มโมเดลขนาด 4B ถึง 9B ที่ทดสอบ ผู้ใช้ภาษาไทยเป็นภาษาแม่ 3 คน ซึ่งให้คะแนนคู่คำแปลแบบไม่ระบุที่มาโดยไม่ทราบว่าโมเดลใดสร้างคำแปลใด เลือก ChindaMT-4B ใน 69% ของการแปลแบบมีกฎ และ 67% โดยรวม หรือมากกว่าสองต่อหนึ่ง สูตรเดียวกันยังช่วยให้โมเดลตั้งต้นอีกรุ่นหนึ่งดีขึ้นภายใต้การตั้งค่าเดียวกัน ซึ่งชี้ว่าผลที่ดีขึ้นมาจากข้อมูล ไม่ได้มาจากโมเดลตั้งต้นตัวใดตัวหนึ่งโดยเฉพาะ
เริ่มใช้งาน
บนเว็บ ChindaMT แปลภาษาไทย-อังกฤษ ให้คุณแปลตามกฎของคุณเอง และเปรียบเทียบผลลัพธ์กับคำแปลที่ไม่ใช้กฎ
ผ่าน API ChindaMT-4B ให้บริการแล้วที่ POST https://api.iapp.co.th/v3/store/text/mt/translate พร้อม endpoint แบบ batch สำหรับข้อความบน UI และเซลล์ในตาราง รับข้อความได้สูงสุด 100,000 ตัวอักษรต่อคำขอ แปลหนึ่งประโยคในประมาณ 0.4 วินาที และห้าหน้าใน 1.7 วินาที ราคา 1 IC ต่อ 400 ตัวอักษรของข้อความต้นฉบับ ไม่คิดค่ากฎ และคำขอที่ล้มเหลวไม่คิดค่าบริการ รายละเอียดทั้งหมดอยู่ในเอกสาร API
curl -X POST https://api.iapp.co.th/v3/store/text/mt/translate \
  -H "apikey: YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"text": "The meeting has been moved to Friday because the boss is busy.", "source_lang": "en", "target_lang": "th", "rules": ["Use a casual, friendly tone"]}'
บนฮาร์ดแวร์ของคุณเอง ทั้งสามขนาดเปิดภายใต้ Apache 2.0 โมเดล 0.8B มีขนาดเล็กพอจะรันบนโน้ตบุ๊กได้
| สิ่งที่เผยแพร่ | ลิงก์ |
|---|---|
| โมเดล (Apache 2.0) | ChindaMT-4B, ChindaMT-2B, ChindaMT-0.8B |
| ข้อมูลเทรน 1.97 ล้านรายการ | ChindaMT-Grounded |
| ชุดประเมินผล | ChindaMT-CoreEval, ChindaMT-BroadEval |
| โค้ด | github.com/iapp-technology/ChindaMT-RGDC |
| บทความวิจัย | arxiv.org/abs/2609.34770 |
องค์กรที่ต้องการให้โมเดลใช้คำศัพท์เฉพาะขององค์กร หรือต้องการติดตั้งแบบ on-premise เพื่อความปลอดภัยของข้อมูล ติดต่อได้ที่ sale@iapp.co.th
ข้อจำกัด
ChindaMT รองรับเฉพาะภาษาไทยและภาษาอังกฤษ โมเดลทำตามกฎประเภทที่คำแปลอ้างอิงที่ดีสามารถแสดงให้เห็นได้ ได้แก่ คำศัพท์ น้ำเสียง ความยาว และรูปแบบผลลัพธ์ อภิธานศัพท์บังคับขนาดใหญ่และโทเคน placeholder ที่ต้องคงไว้อย่างเคร่งครัดอยู่นอกขอบเขตที่เทรนมา เช่นเดียวกับการแปลด้วยเครื่องทุกระบบ โมเดลอาจสร้างข้อความที่อ่านลื่นไหลแต่ไม่ถูกต้อง คำแปลสำหรับงานด้านกฎหมาย การแพทย์ และงานอื่นที่มีความเสี่ยงสูงจึงควรผ่านการตรวจทานโดยคน โดย API จะระบุจุดที่น่าจะมีปัญหาไว้ในฟิลด์ warnings
กิตติกรรมประกาศ
ChindaMT เป็นผลงานของทีม iApp AI Research ร่วมกับ ศ. ดร.ธนารักษ์ ธีระมั่นคง ขอขอบคุณ SiamAI ที่สนับสนุนทรัพยากรการประมวลผล OpenThai Lab ที่ให้การสนับสนุน และผู้ใช้ภาษาไทยเป็นภาษาแม่ 3 ท่านที่อาสาเป็นผู้ประเมิน
หากให้กฎกับนักแปลได้เพียงข้อเดียว คุณจะเลือกกฎใด ลองใช้ได้ที่หน้าแปลภาษา แล้วบอกเราได้ที่ Discord