OpenThai 2.0 Legal — AI กฎหมายไทยที่จำตัวบทได้ขึ้นใจ และนำไปรันเองได้

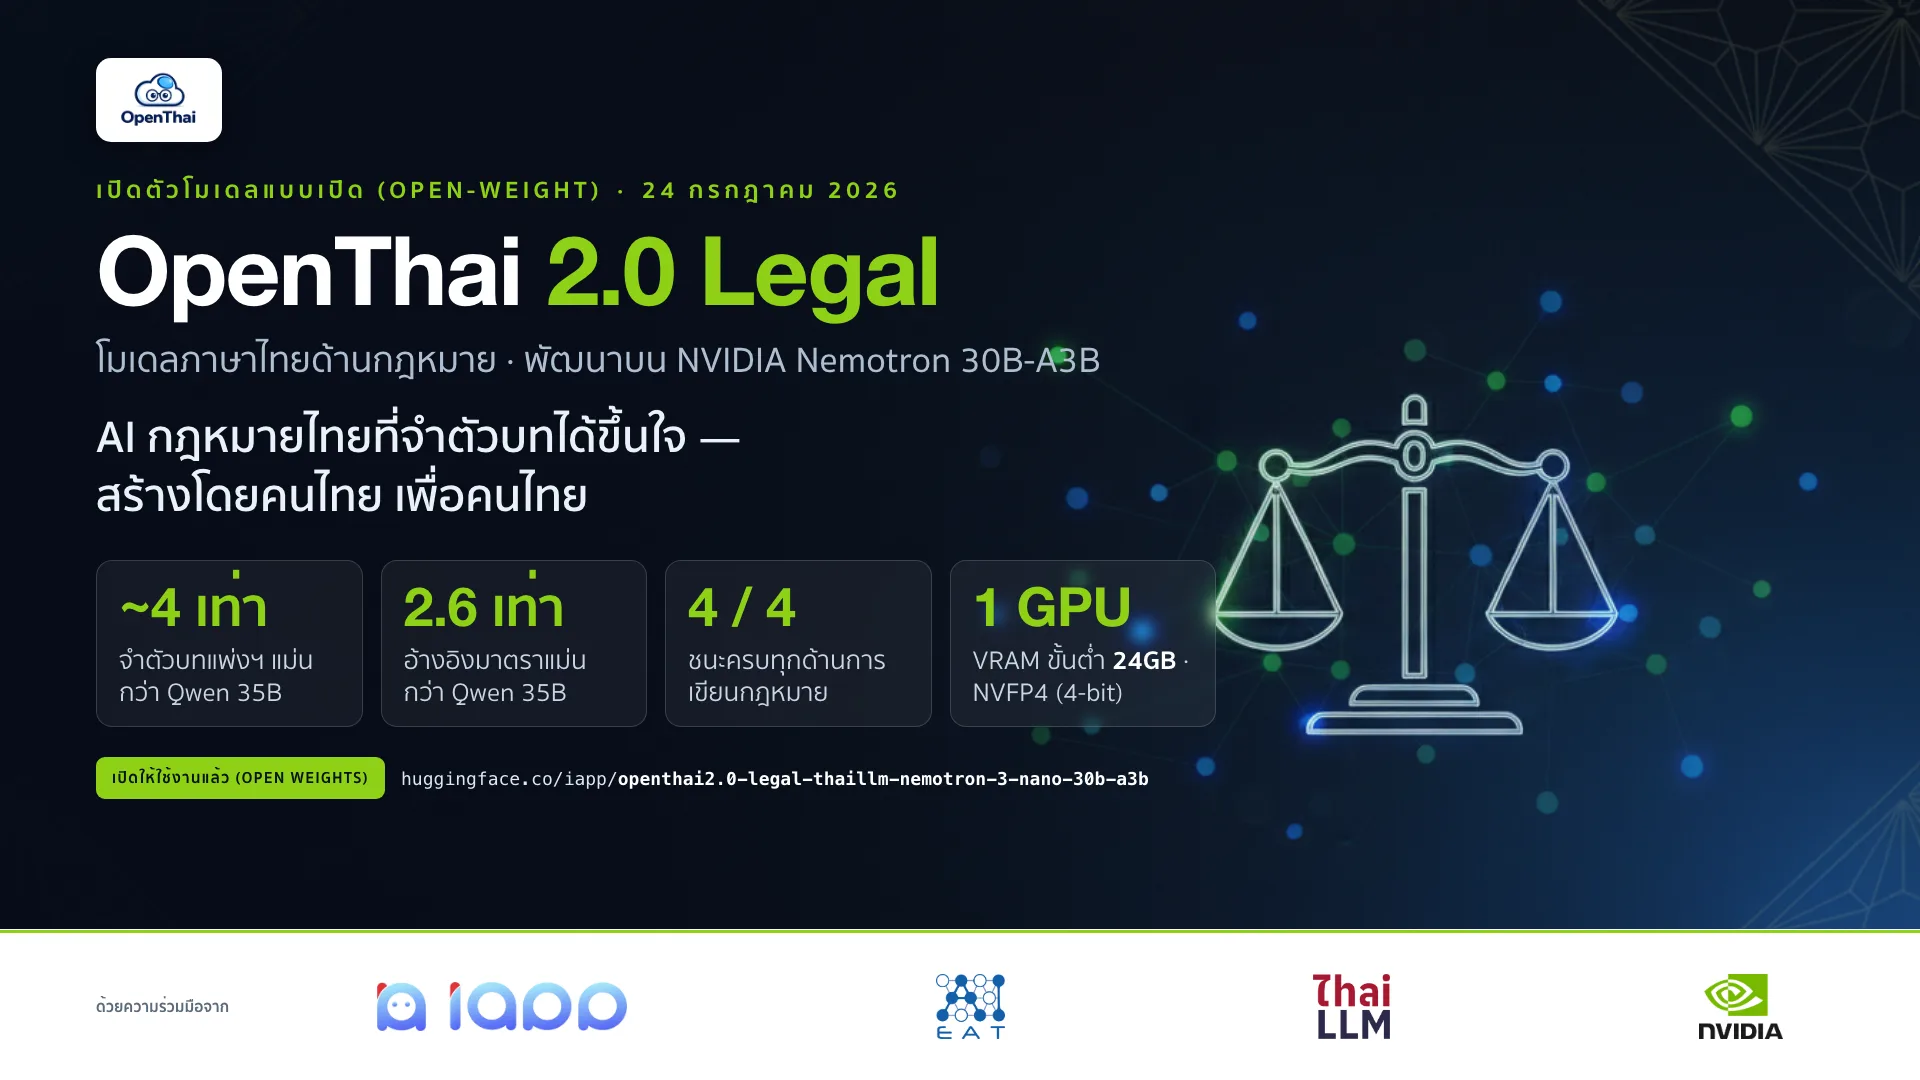
วันนี้เราขอเปิดตัว OpenThai 2.0 Legal โมเดลภาษาขนาดใหญ่แบบเปิด (open-weight) ที่พัฒนาขึ้นเพื่องานกฎหมายไทยโดยเฉพาะ พร้อมเปิดให้ดาวน์โหลดน้ำหนักโมเดลได้ฟรีบน Hugging Face โมเดลนี้สร้างโดยคนไทย เพื่อคนไทย สำหรับทนายความ ที่ปรึกษากฎหมายภายในองค์กร ทีมกำกับดูแล ผู้พัฒนาเทคโนโลยีทางกฎหมาย และหน่วยงานภาครัฐ ที่ต้องการคำตอบด้านกฎหมายและคำพิพากษาไทยที่เชื่อถือได้และอ้างอิงแหล่งที่มาได้
หน้าโมเดล: iapp.co.th/openmodels/openthai2p0-legal · ดาวน์โหลด: huggingface.co/iapp/openthai2.0-legal-thaillm-nemotron-3-nano-30b-a3b
รู้กฎหมายโดยไม่ต้องมีใครบอกตัวบท
แชตบอตกฎหมายส่วนใหญ่เก่งได้เท่าที่เอกสารที่เราป้อนให้เท่านั้น พอไม่มีเอกสาร ก็เดา
แต่เมื่อถาม OpenThai 2.0 Legal โดยไม่ใส่ตัวบทกฎหมายมาในคำถามเลย โมเดลยังจดจำและอ้างอิงชื่อกฎหมายและ มาตรา ที่ถูกต้องได้จากความจำของตนเอง ผลการทดสอบที่ตรวจให้คะแนนด้วยโปรแกรมชี้ว่า โมเดลนี้จดจำตัวบทกฎหมายไทยได้แม่นที่สุดในบรรดาโมเดลที่ผู้ใช้นำไปรันเองได้ โดยจำได้แม่นกว่าโมเดล Qwen3.6-35B ซึ่งใหญ่กว่ามากถึง ราว 4 เท่า ในหมวดประมวลกฎหมายแพ่งและพาณิชย์ และ ชนะครบทั้งสี่ด้าน ในการประเมินการเขียนวิเคราะห์แบบข้อสอบเนติบัณฑิตเมื่อเทียบกับคู่แข่งรายเดียวกัน ตั้งแต่ความถูกต้องของการอ้างอิงไปจนถึงการให้เหตุผลทางกฎหมาย
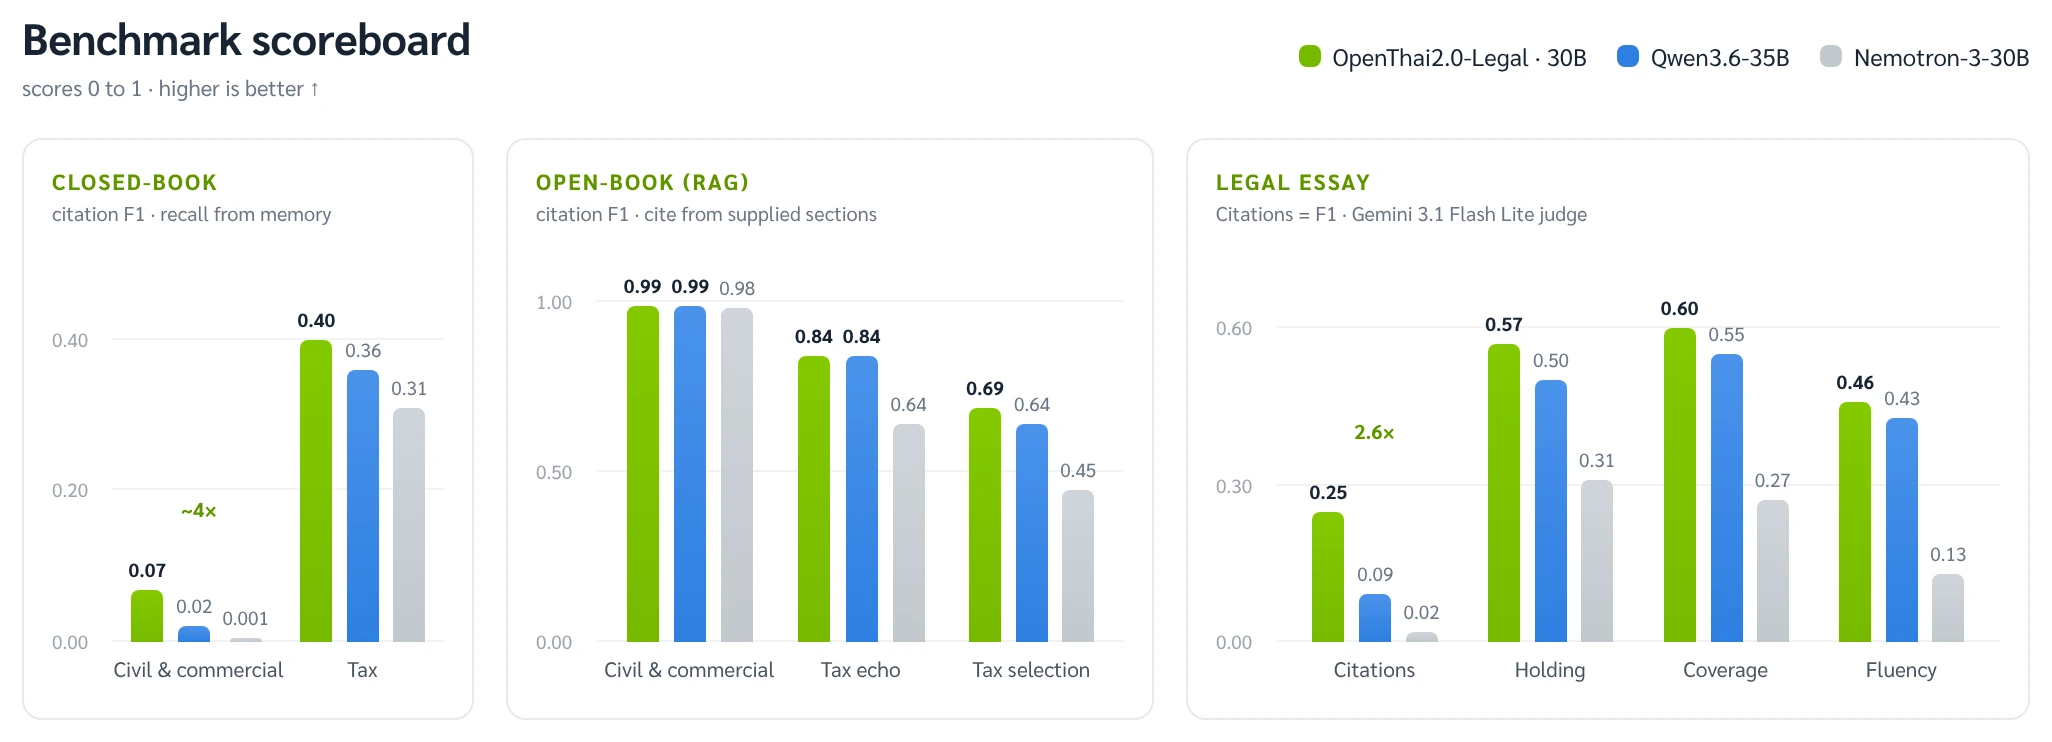
| การประเมิน | OpenThai 2.0 Legal | Qwen3.6-35B | Nemotron-3-30B (ฐาน) |
|---|---|---|---|
| Closed-book · จำประมวลกฎหมายแพ่งและพาณิชย์ (n=3,729) | 0.07 | 0.02 | 0.001 |
| Closed-book · จำประมวลรัษฎากร (n=50) | 0.40 | 0.36 | 0.31 |
| Open-book · อ้างมาตราจากบริบท (n=3,729) | 0.99 | 0.99 | 0.98 |
| Open-book · ภาษี echo (n=50) | 0.84 | 0.84 | 0.64 |
| Open-book · ภาษี เลือกมาตราท่ามกลางตัวลวง (n=50) | 0.69 | 0.64 | 0.45 |
| บทวิเคราะห์ · ความถูกต้องของการอ้างอิง (n=72) | 0.25 | 0.09 | 0.02 |
| บทวิเคราะห์ · สรุปข้อวินิจฉัยถูกต้อง (n=72) | 0.57 | 0.50 | 0.31 |
| บทวิเคราะห์ · ครอบคลุมประเด็นสำคัญ (n=72) | 0.60 | 0.55 | 0.27 |
| บทวิเคราะห์ · คุณภาพการเขียน (n=72) | 0.46 | 0.43 | 0.13 |
คะแนนอยู่ระหว่าง 0 ถึง 1 ยิ่งสูงยิ่งดี แถวที่เป็นการอ้างอิงใช้ตัวให้คะแนน citation-F1 ของ NitiBench ส่วนข้อวินิจฉัย ความครอบคลุม และคุณภาพการเขียน ตัดสินโดย Gemini 3.1 Flash Lite ทุกโมเดลถูกรันใหม่ทั้งหมดภายใต้โปรโตคอลเดียวกัน คือรันครั้งเดียว ปิดโหมดคิด และตรวจการอ้างอิงด้วยโปรแกรม ไม่ใช้ AI เป็นผู้ตัดสิน
ขอบอกข้อจำกัดไว้ตรงนี้เลยอย่างตรงไปตรงมา ยังมีบริการคลาวด์แบบปิดที่จำกฎหมายไทยได้มากกว่าเรา ข้อความของเราจึงจำกัดเฉพาะ โมเดลที่คุณนำไปรันบนเครื่องของตนเองได้ ซึ่งในกลุ่มนั้น นี่คือผลดีที่สุดเท่าที่เราวัดได้
ทุกคำตอบระบุแหล่งที่มา
การรู้กฎหมายเป็นเพียงครึ่งเดียว งานกฎหมายต้องการคำตอบที่ตรวจสอบได้
OpenThai 2.0 Legal ส่งคืนชื่อกฎหมายและมาตราที่ถูกต้องในรูปแบบ JSON ที่กำหนดไว้ตายตัว
{"answer": "นาย ก. ต้องรับผิดตามประมวลกฎหมายแพ่งและพาณิชย์ มาตรา 420",
 "citations": [{"law": "ประมวลกฎหมายแพ่งและพาณิชย์", "section": "420"}]}
นี่ไม่ใช่แค่เรื่องความสวยงามของรูปแบบ แต่คือสิ่งที่ทำให้โมเดลนำไปใช้ในซอฟต์แวร์ได้จริง การอ้างอิงถูกแปลงเข้าสู่ระบบ RAG เครื่องมือร่างเอกสาร และกระบวนการตรวจทานได้ทันที และผู้ตรวจสามารถพิสูจน์การอ้างอิงแต่ละรายการกับตัวบทได้ แทนที่จะต้องเชื่อ
ในโหมด RAG โมเดลจะได้รับมาตราที่คัดมาให้ แล้วอ้างอิงเฉพาะมาตราที่ใช้บังคับจริงเท่านั้น ใช้ได้กับระบบค้นคืนเอกสารที่คุณมีอยู่แล้ว ไม่ผูกกับโมเดล embedding หรือ rerank ตัวใดเป็นการเฉพาะ และเพราะความสามารถแบบ closed-book แข็งแรงอยู่แล้ว คำถามจำนวนมากจึงไม่ต้องใช้ระบบค้นคืนเลย
รันบนเครื่องของคุณเองได้
ข้อนี้สำคัญยิ่งกว่าตัวเลขในชุดทดสอบใด ๆ เพราะสำนวนคดี ข้อมูลลูกความ และการสอบสวนภายใน คือข้อมูลที่องค์กรส่งออกไปยังคลาวด์ของคนอื่นไม่ได้
OpenThai 2.0 Legal เป็นโมเดล Mixture-of-Experts ขนาด 3 หมื่นล้านพารามิเตอร์ ที่ทำงานจริงเพียง ~3 พันล้านพารามิเตอร์ต่อโทเคน จึงรันได้บน GPU เพียงตัวเดียวที่มี VRAM เริ่มต้น 24 GB ด้วย NVFP4 (4-bit) หรือหากต้องการความแม่นยำเต็มรูปแบบ (bfloat16) ก็รันได้บน H100 สองตัว สำนักงานกฎหมาย ธนาคาร และหน่วยงานภาครัฐ จึงเก็บงานที่เป็นความลับไว้ภายในองค์กรได้ทั้งหมด ภายใต้การกำกับดูแลของตนเอง
สร้างขึ้นมาอย่างไร
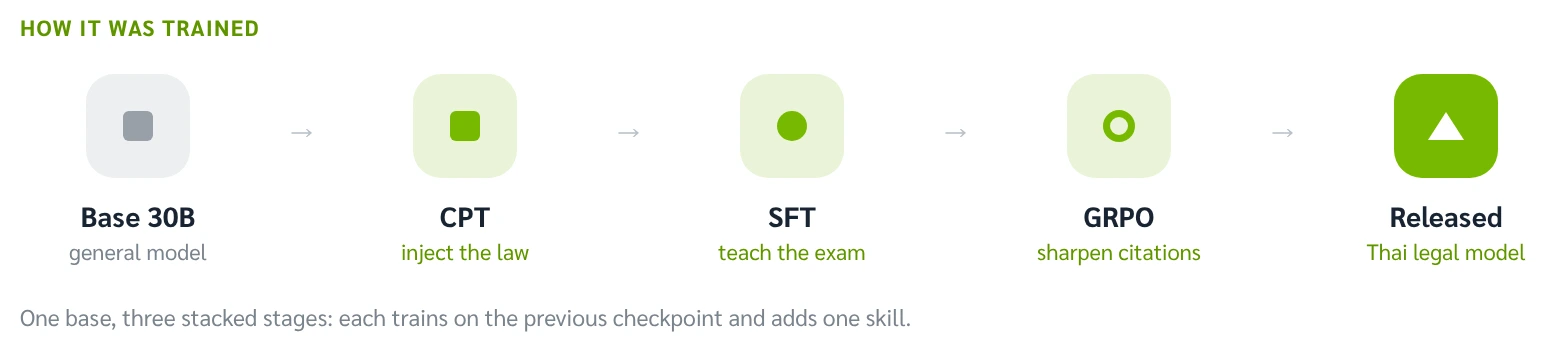
สามขั้นตอนบนแพลตฟอร์ม NVIDIA NeMo แต่ละขั้นแก้ปัญหาคนละอย่าง
- CPT — ฝังตัวบทกฎหมาย โมเดลฝึกอ่านตัวบทเต็มของทุกมาตราทั้งสองทิศทาง (ท่องตัวบทจากเลขมาตรา และระบุเลขมาตราจากใจความ) ความรู้จึงฝังอยู่ในน้ำหนักโมเดล รวม 360,985 แบบฝึก ราว 800 ล้านโทเคนกฎหมายไทย
- SFT — สอนให้ตอบแบบข้อสอบ ทุกคำตอบอยู่ในรูปแบบ JSON ที่กำหนดไว้ และอ้างเฉพาะมาตราที่ได้รับมา รวม 16,436 ตัวอย่างคำตอบข้อสอบและบทวิเคราะห์เนติบัณฑิต
- GRPO — ขัดเกลาการอ้างอิงให้คม การเรียนรู้แบบเสริมกำลังที่ใช้ค่า citation F1 ของชุดทดสอบเป็นรางวัล อ้างถูกตรงเป๊ะจะได้รับการเสริมแรง ถ้าเพิ่มมาตราที่ผิดมาจะถูกกด รวม 8,568 คำถามที่ให้คะแนน ราว 68,500 ร่างคำตอบ
โมเดลฐานคือ Nemotron-3-Nano-30B-A3B ของ NVIDIA ซึ่งเป็น MoE แบบผสม Mamba-Transformer และใช้ Megatron-Bridge สำหรับ CPT/SFT กับ NeMo-RL สำหรับ GRPO
ทดลองเลยตอนนี้ — สด ฟรี ไม่ต้องมี GPU
ถามคำถามกฎหมายไทยกับโมเดลจริงได้จากหน้านี้เลย
ถามเป็นภาษาไทย คำตอบอ้างอิงกฎหมายไทย 39 ฉบับ ราว 6,300 มาตรา และแสดงมาตราที่ใช้ทุกครั้ง
วิเคราะห์กฎหมายแบบความเรียงเต็มรูปแบบ พร้อมอ้างมาตราจากตัวบทฉบับปัจจุบันที่ระบบค้นให้
มุมมองนักพัฒนา — คำสั่ง API เบื้องหลังเดโมนี้
คำสั่ง curl นี้อัปเดตสดตามคำถาม โหมด และตัวเลือกที่คุณตั้งด้านบน คัดลอกไปรันในเทอร์มินัลด้วย API key ของคุณได้เลย — เป็นคำขอเดียวกับที่หน้านี้ส่งจริง
curl -s https://api.iapp.co.th/v3/llm/openthai2p0-legal/chat/completions \
  -H "Content-Type: application/json" \
  -H "apikey: YOUR_IAPP_API_KEY" \
  -d '{
  "model": "openthai2.0-legal",
  "rag": true,
  "rag_inject": "system",
  "messages": [
    {
      "role": "system",
      "content": "You are a Thai legal expert. Answer with legal analysis and cite the relevant มาตรา."
    },
    {
      "role": "user",
      "content": "จำเลยขีดฆ่าและฉีกเอกสารหลักฐานแห่งหนี้ แม้ยังอ่านได้ ถือเป็นความผิดสำเร็จหรือเพียงพยายามกระทำผิด"
    }
  ],
  "temperature": 0,
  "top_p": 1,
  "max_tokens": 4096,
  "chat_template_kwargs": {
    "enable_thinking": true
  },
  "stream": true,
  "stream_options": {
    "include_usage": true
  }
}'
ผลลัพธ์เป็นเครื่องมือช่วยตัดสินใจ มิใช่คำปรึกษาทางกฎหมาย โปรดตรวจสอบการอ้างอิงกับตัวบทฉบับปัจจุบันทุกครั้ง
และนี่คือระบบเต็มรูปแบบสำหรับใช้งานจริง ไม่ใช่ของเล่น: API นี้มี RAG ในตัว — ค้นคืนแบบไฮบริดจากคลังตัวบทกฎหมายไทย 39 ฉบับ กว่า 6,300 มาตรา (BM25 + vector + reranker) แล้วให้โมเดลตอบโดยอ้างอิงตัวบทฉบับปัจจุบัน พร้อมแสดงมาตราที่ระบบเลือกมาใต้คำตอบทุกครั้ง อยากรู้ว่าโมเดลเปล่าทำได้แค่ไหน? แท็บ "ปิดตำรา" ("rag": false ใน API) คือโหมดเปรียบเทียบ และถ้าต้องการสร้างระบบค้นคืนแบบเดียวกันบนเครื่องของคุณเอง: คู่มือ Open WebUI และ OpenThaiRAG พาไปถึงจุดนั้นได้ภายในหนึ่งชั่วโมง
และ endpoint เดียวกันนี้เปิดให้คุณนำไปต่อยอดได้ทันที เป็น API โฮสต์ให้ฟรี — รองรับรูปแบบ OpenAI ใช้ฟรีถึง 30 กันยายน 2569 (ขยายเวลาจากกำหนดเดิม 24 สิงหาคม) เพียงมี iApp API key ซึ่งสมัครฟรี (สมัคร → API Keys; จำกัด 30 คำขอ/นาที) หลังหมดโปรโมชันยังใช้ต่อได้ในราคามาตรฐานเท่ากับ Thanoy คือ 0.01/0.02 IC ต่อ 1พันโทเคน เข้า/ออก
อัปเดต 3 ตุลาคม 2569: สิ้นสุดช่วงใช้ฟรีแล้ว API ที่โฮสต์ให้คิด 0.01 IC ต่อ 1,000 input tokens และ 0.02 IC ต่อ 1,000 output tokens
from openai import OpenAI
client = OpenAI(base_url="https://api.iapp.co.th/v3/llm/openthai2p0-legal", api_key="YOUR_IAPP_API_KEY")

r = client.chat.completions.create(
    model="openthai2.0-legal",
    messages=[{"role": "user", "content": "ลักทรัพย์ในเวลากลางคืน ผิดมาตราใด"}],
    max_tokens=1024,
)
print(r.choices[0].message.content)
หรือจะรันเองก็ได้ใน 5 นาที
vllm serve iapp/openthai2.0-legal-thaillm-nemotron-3-nano-30b-a3b \
  --tensor-parallel-size 2 --trust-remote-code \
  --max-model-len 32768 --enforce-eager
จากนั้นเรียกใช้ผ่านไคลเอนต์ใดก็ได้ที่รองรับรูปแบบ OpenAI หรือจะใช้ NVIDIA NIM ซึ่งเปิด endpoint แบบเดียวกันก็ได้ ดู prompt เต็ม ค่าที่แนะนำสำหรับการสร้างคำตอบ และตัวอย่างครบทั้งสามโหมด (RAG, closed-book และการเขียนวิเคราะห์) ได้ที่หน้าโมเดล
สิ่งที่โมเดลนี้ยังทำไม่ได้
เราขอบอกเองดีกว่าให้ท่านไปเจอเองทีหลัง
- คุณภาพของระบบค้นคืนมีผลโดยตรง ถ้าให้มาตราที่ถูก การอ้างอิงจะเกือบสมบูรณ์ ถ้าให้มาตราที่ผิด คำตอบก็จะผิดตาม
- การแยกมาตราที่ใกล้เคียงกันคือส่วนที่ยากที่สุด การแยกมาตราที่ใช้บังคับออกจากมาตราที่คล้ายกัน เป็นด้านที่ได้คะแนนต่ำที่สุดของทุกโมเดลที่ทดสอบ รวมถึงของเราด้วย
- ขอบเขตความรู้มีขีดจำกัด การฝึกเน้นกฎหมายลายลักษณ์อักษรของไทยและข้อหารือของกรมสรรพากร สาขาเฉพาะทางหรือการแก้ไขกฎหมายล่าสุดอาจยังบางกว่า และกฎหมายเปลี่ยนแปลงได้เสมอ
- เป็นเครื่องมือช่วยตัดสินใจ มิใช่คำปรึกษาทางกฎหมาย ผู้ประกอบวิชาชีพควรตรวจสอบการอ้างอิงทุกครั้งกับตัวบทฉบับปัจจุบันก่อนนำไปใช้
ทำไมเราถึงเปิดให้ใช้ฟรี
"กฎหมายไทยสมควรมี AI ที่รู้กฎหมายไทยจริง ๆ และเป็น AI ที่องค์กรไทยเป็นเจ้าของและรันเองได้ การเปิดเผยน้ำหนักโมเดล OpenThai 2.0 Legal แบบเปิด คือการส่งมอบโมเดลกฎหมายที่ทรงพลังและรันเองได้ ให้อยู่ในมือของทนายความ นักพัฒนา และสถาบันไทยทุกแห่ง นี่คือผลงานที่สร้างโดยคนไทย เพื่อประเทศไทย"
— ดร.กอบกฤตย์ วิริยะยุทธกร ประธานเจ้าหน้าที่บริหาร บริษัท iApp Technology
อธิปไตยทาง AI ไม่ได้อยู่ที่ว่าใครเป็นเจ้าของพลังประมวลผลเท่านั้น แต่อยู่ที่ว่าใครสามารถสร้าง ตรวจสอบ และพัฒนาโมเดลได้ด้วย ทุกห้องปฏิบัติการในมหาวิทยาลัย ทุกสตาร์ทอัพ และทุกหน่วยงานที่นำโมเดลนี้ไปปรับแต่ง ประเมินผล หรือใช้งานจริง ล้วนช่วยเสริมขีดความสามารถด้าน AI ของประเทศไทยโดยรวม และสูตรเดียวกันนี้ก็ใช้ได้กับทุกภาษาและทุกระบบกฎหมายที่ยังรอโมเดลของตนเองอยู่
OpenThai 2.0 Legal พัฒนาโดยทีม OpenThai (AIEAT / iApp Technology) บนแพลตฟอร์ม NVIDIA Nemotron และ NeMo ร่วมกับ สถาบันข้อมูลขนาดใหญ่ (BDI) โครงการ ThaiLLM และ NVIDIA
เริ่มต้นใช้งาน
- หน้าโมเดล: iapp.co.th/openmodels/openthai2p0-legal
- ดาวน์โหลดน้ำหนักโมเดล: huggingface.co/iapp/openthai2.0-legal-thaillm-nemotron-3-nano-30b-a3b
- ต้องการความช่วยเหลือในการติดตั้ง หรืออยากได้โมเดลที่ปรับจูนกับคลังเอกสารของคุณ: sale@iapp.co.th · 02-124-4041
- ชุมชน: Discord